实验八、为VPC扩展IP地址并配置EKS Pod使用独立的IP地址段
本文介绍如何为VPC扩展IP地址并配置EKS Pod使用独立子网,解决大规模容器部署时VPC可用IP不足的问题,通过AWS VPC CNI实现Pod与Node网段隔离。
EKS动手实验合集请参考这里。
EKS 1.36版本 @2026 AWS Global区域测试通过
一、背景及网络场景选择
1、关于EKS的默认CNI
AWS EKS默认使用AWS VPC CNI(了解更多点这里),所有的Pod都将自动获得一个本VPC内的IP地址,从外部网络看Pod,它们的表现就如同一个普通EC2。这是AWS EKS默认的网络模式,也是强烈推荐的使用模式。
2、需要额外IP的解决方案(三选一)
某些场景下,可能当前创建VPC时候预留IP地址过少,要大规模启动容器会遇到VPC内可用IP地址不足。此时有几个办法:
(1)方案一、创建全新的VPC运行EKS
由于云上可以随时创建多个VPC,并可通过多种方式实现VPC和应用之间的互通,因此创建一个独立的VPC运行新的应用是最快捷的解决地址不足的办法。EKS的命令行管理工具eksctl默认的参数就是创建一个全新VPC。当创建全新VPC后,一般可通过如下方式让两个VPC之间的服务互通:
- 路由模式。如果两个VPC IP地址段不重叠且可路由,可通过VPC Peering或Transit Gateway打通两个VPC网络,实现三层和四层协议的全面互通;
- 通过公网方式。在一个VPC上的应用前配置好ELB并对外发布服务,然后对ELB可限制来源IP白名单,仅允许另一个VPC访问;
- 通过内网方式。在一个VPC上配置PrivateLink映射Endpoint Service,并在另一个VPC内提供Endpoint服务。
除此以外,可能还有其他方式用于实现跨VPC的应用互访,再次不逐个罗列。
(2)方案二、更换Kubernetes社区的CNI并配置EKS Pod使用非VPC IP地址
如果希望EKS上的Pod完全不使用本VPC的IP地址,可以更换EKS的CNI网络插件,官方文档这里做了介绍。在集群创建后,可删除默认的AWS VPC CNI,然后安装采用Overlay网络的第三方CNI,由该CNI从独立的Pod CIDR中分配地址。
需要注意的是,AWS EKS在EC2节点上唯一提供支持的CNI是Amazon VPC CNI,替换为第三方CNI后相关问题需由该插件的商业支持方或使用者自行承担。目前AWS在官方文档中列出的合作伙伴CNI包括Tigera的Calico、Isovalent的Cilium、Juniper的Cloud-Native Contrail Networking以及VMware的Antrea。早期文档中常被提及的WeaveNet已随Weaveworks公司停止运营而终止维护,其代码仓库已归档并不再接收安全补丁,因此不应再用于新建集群。
(3)方案三、为VPC扩展IP地址并配置EKS Pod使用独立的IP地址段
VPC和EKS都支持使用扩展地址段。在此方案下,继续使用EKS默认的VPC CNI,首先为现有VPC扩展IP地址,并配置EKS使用扩展IP地址。本方案影响较小,过度平滑,不需要额外创建VPC,也不需要重新部署EKS网络CNI。
要添加的IP,通常是VPC的CIDR扩展,或者是100.64的保留网段。AWS云上100.64是定义为保留网段使用。
需要注意的是,扩展IP地址存在范围限制,并不是任意IP都可以添加到VPC的扩展范围内,请注意参考这里文档描述的限制范围。如果此IP段不可接受,则应考虑其他方案。
在方案三的内部,AWS VPC CNI又提供了两条实现路径,其差异需要在动手之前明确。
第一条路径是本文采用的自定义网络(Custom Networking)。该路径通过名为ENIConfig的自定义资源,为每个可用区显式指定一个Pod专用子网,VPC CNI在该子网中创建二级弹性网络接口并从中分配Pod的IP地址。此时节点主网络接口所在的子网不再向Pod分配地址,Pod网段与Node网段完全隔离,并且可以为Pod单独指定安全组。代价是配置项较多,且启用后必须重建节点组才能生效。
第二条路径是增强子网发现(Enhanced Subnet Discovery),自VPC CNI 1.18.0起默认开启,对应的环境变量为ENABLE_SUBNET_DISCOVERY=true。该路径不需要创建ENIConfig资源,只需为扩展CIDR中新建的子网打上标签kubernetes.io/role/cni,值为1,VPC CNI便会自动发现同一VPC同一可用区内的这些子网并从中补充Pod地址。其优势是既有节点组可以原地继续使用,无需重建;代价是Pod地址可能来自节点子网也可能来自新增子网,两个网段并不严格隔离,也无法为Pod单独指定安全组。
当两项功能同时启用时,自定义网络的优先级高于增强子网发现。因此本文后续步骤在启用自定义网络之后,ENABLE_SUBNET_DISCOVERY保持默认值即可,不会与自定义网络产生冲突。
若读者的实际目标仅是缓解IP地址不足,而不要求Pod与Node网段严格分离,可以只执行本文第二章为VPC扩展地址段并为新子网补充kubernetes.io/role/cni标签,跳过第四章的自定义网络配置与节点组重建,成本与影响都更小。
本文描述方案三中的自定义网络路径,即为VPC扩展IP并为Pod指定独立子网。
3、为VPC扩展IP地址并配置EKS Pod使用独立的IP地址段的架构图
如上文描述,为VPC扩展IP地址并配置EKS Pod使用独立的IP地址段。架构图如下。
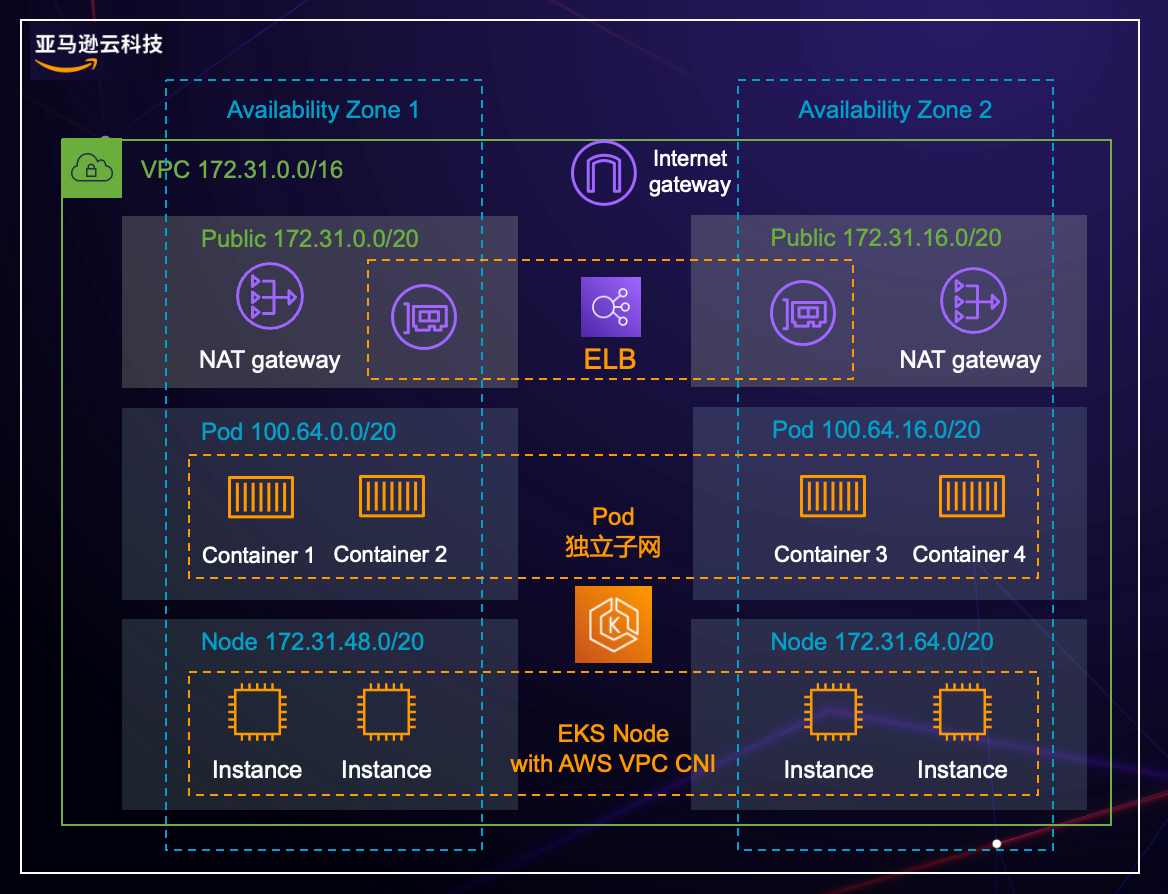
在这张图内,以AZ1的网络为例进行讲解,分成几个层面:
- VPC的CIDR是172.31.0.0/16,因此现有的子网都在这个范围内
- 部署NAT Gateway的公有子网,分配了是172.31.0.0/20的子网
- 部署EKS的Nodegroup的节点组是在私有子网,分配了172.31.48.0/20的子网
- 为了模拟VPC扩容,在VPC上新增了100.64.0.0/16的网段,并且分配了一个Pod专用子网100.64.0.0/20,且这个子网也是私有子网,对互联网的交互是依赖NAT Gateway的
下面开始描述配置过程。
二、为现有VPC扩展地址段
1、为VPC添加新的IP地址
首先查看当前VPC的IP范围,并查看AWS官方文档描述的可扩充IP范围的限制。
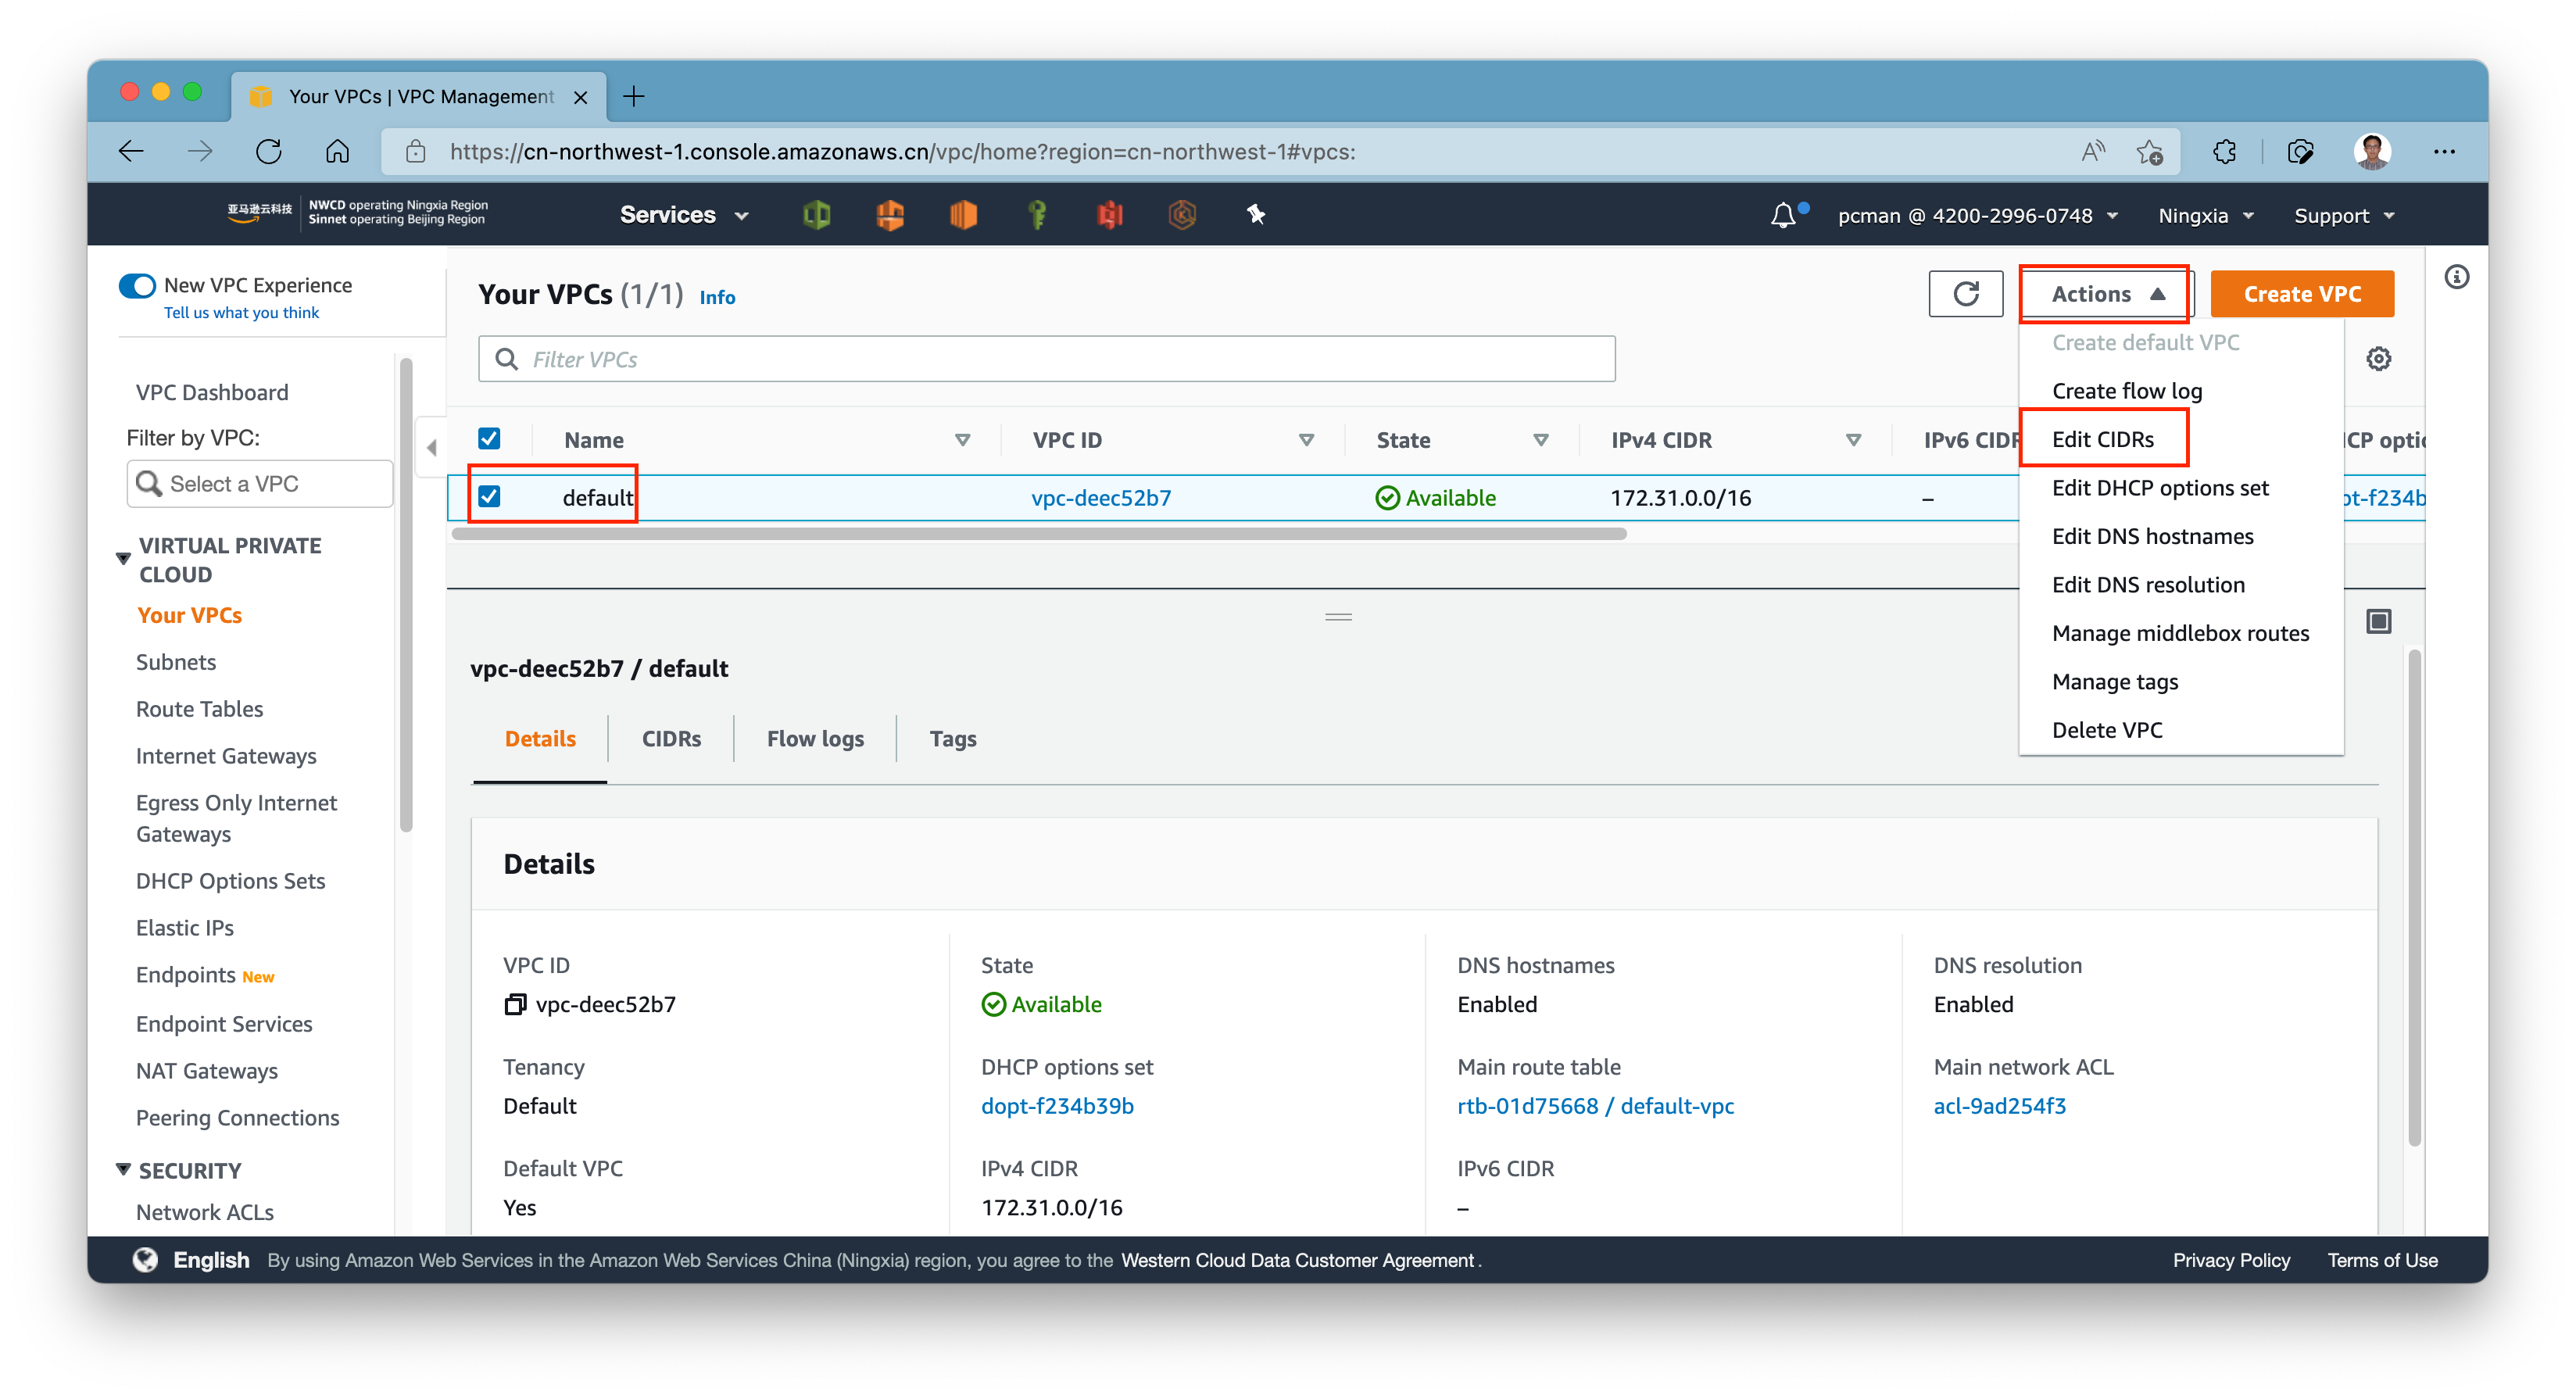
首先进入VPC界面,选择要添加IP地址的VPC,点击右上角的操作,选择修改CIDR。如下截图。
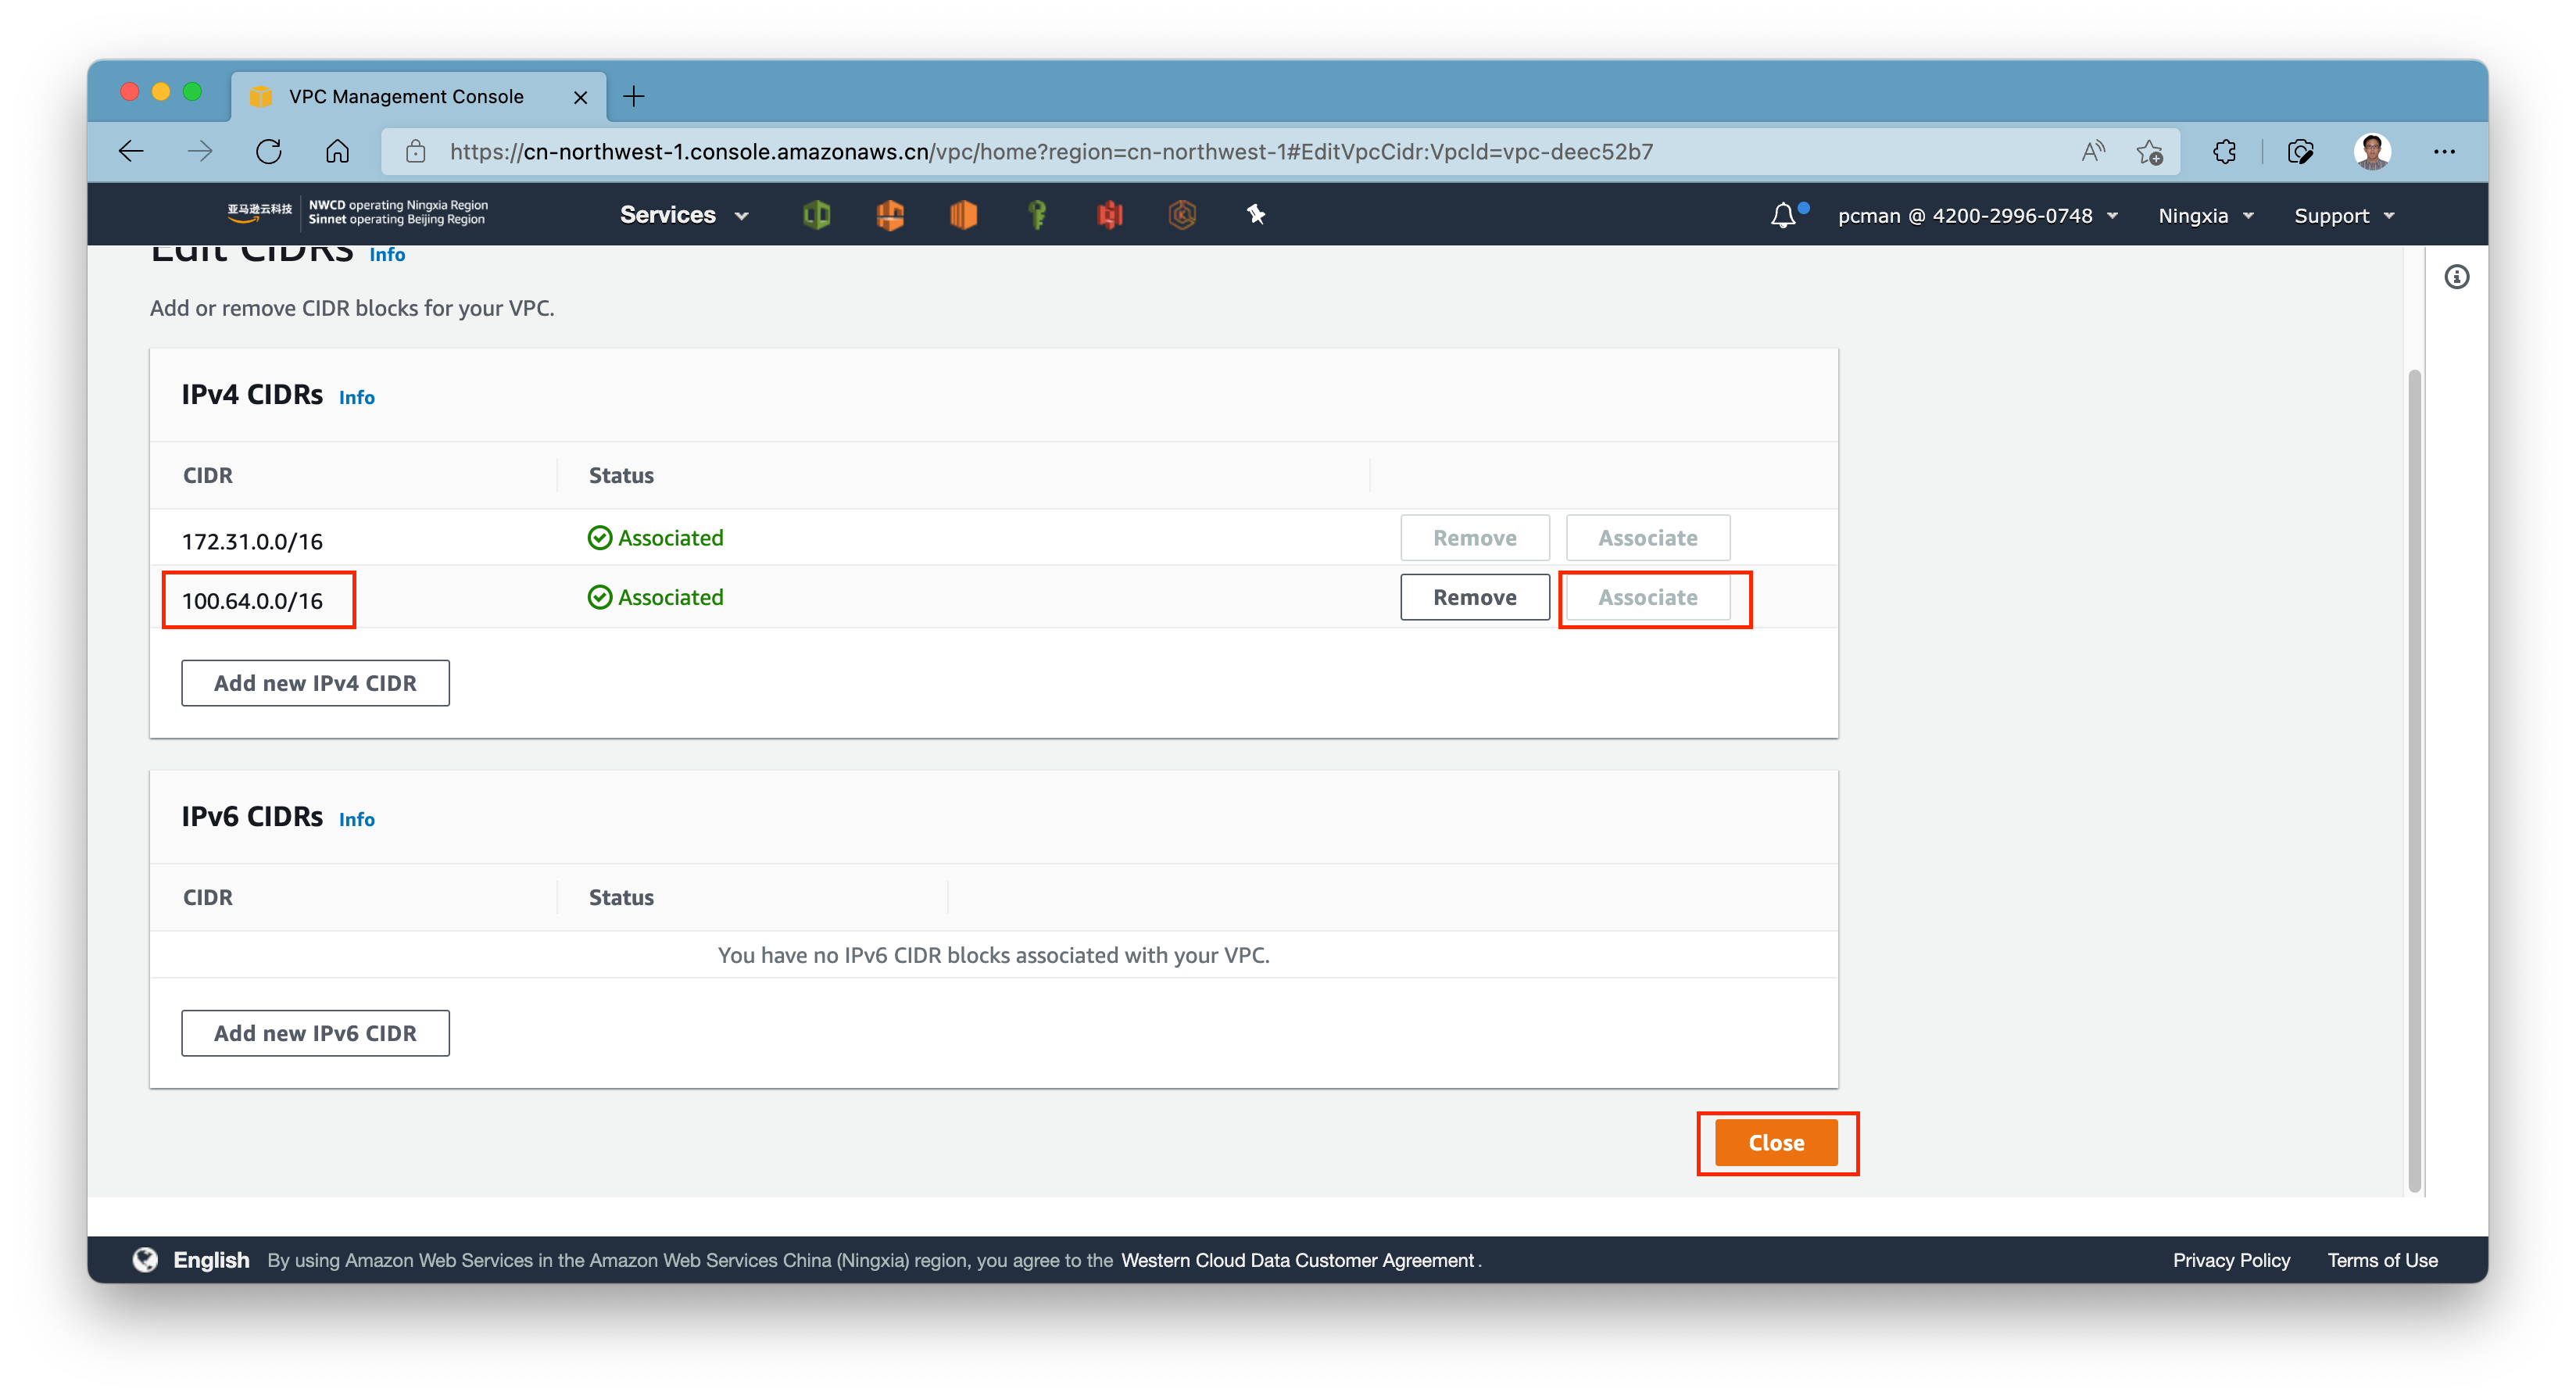
进入添加IP地址段界面,添加上第二个地址段,例如100.64.0.0/16,然后点击右侧的分配按钮,再点击下方的保存。如下截图。
2、为新的IP地址段创建新的子网
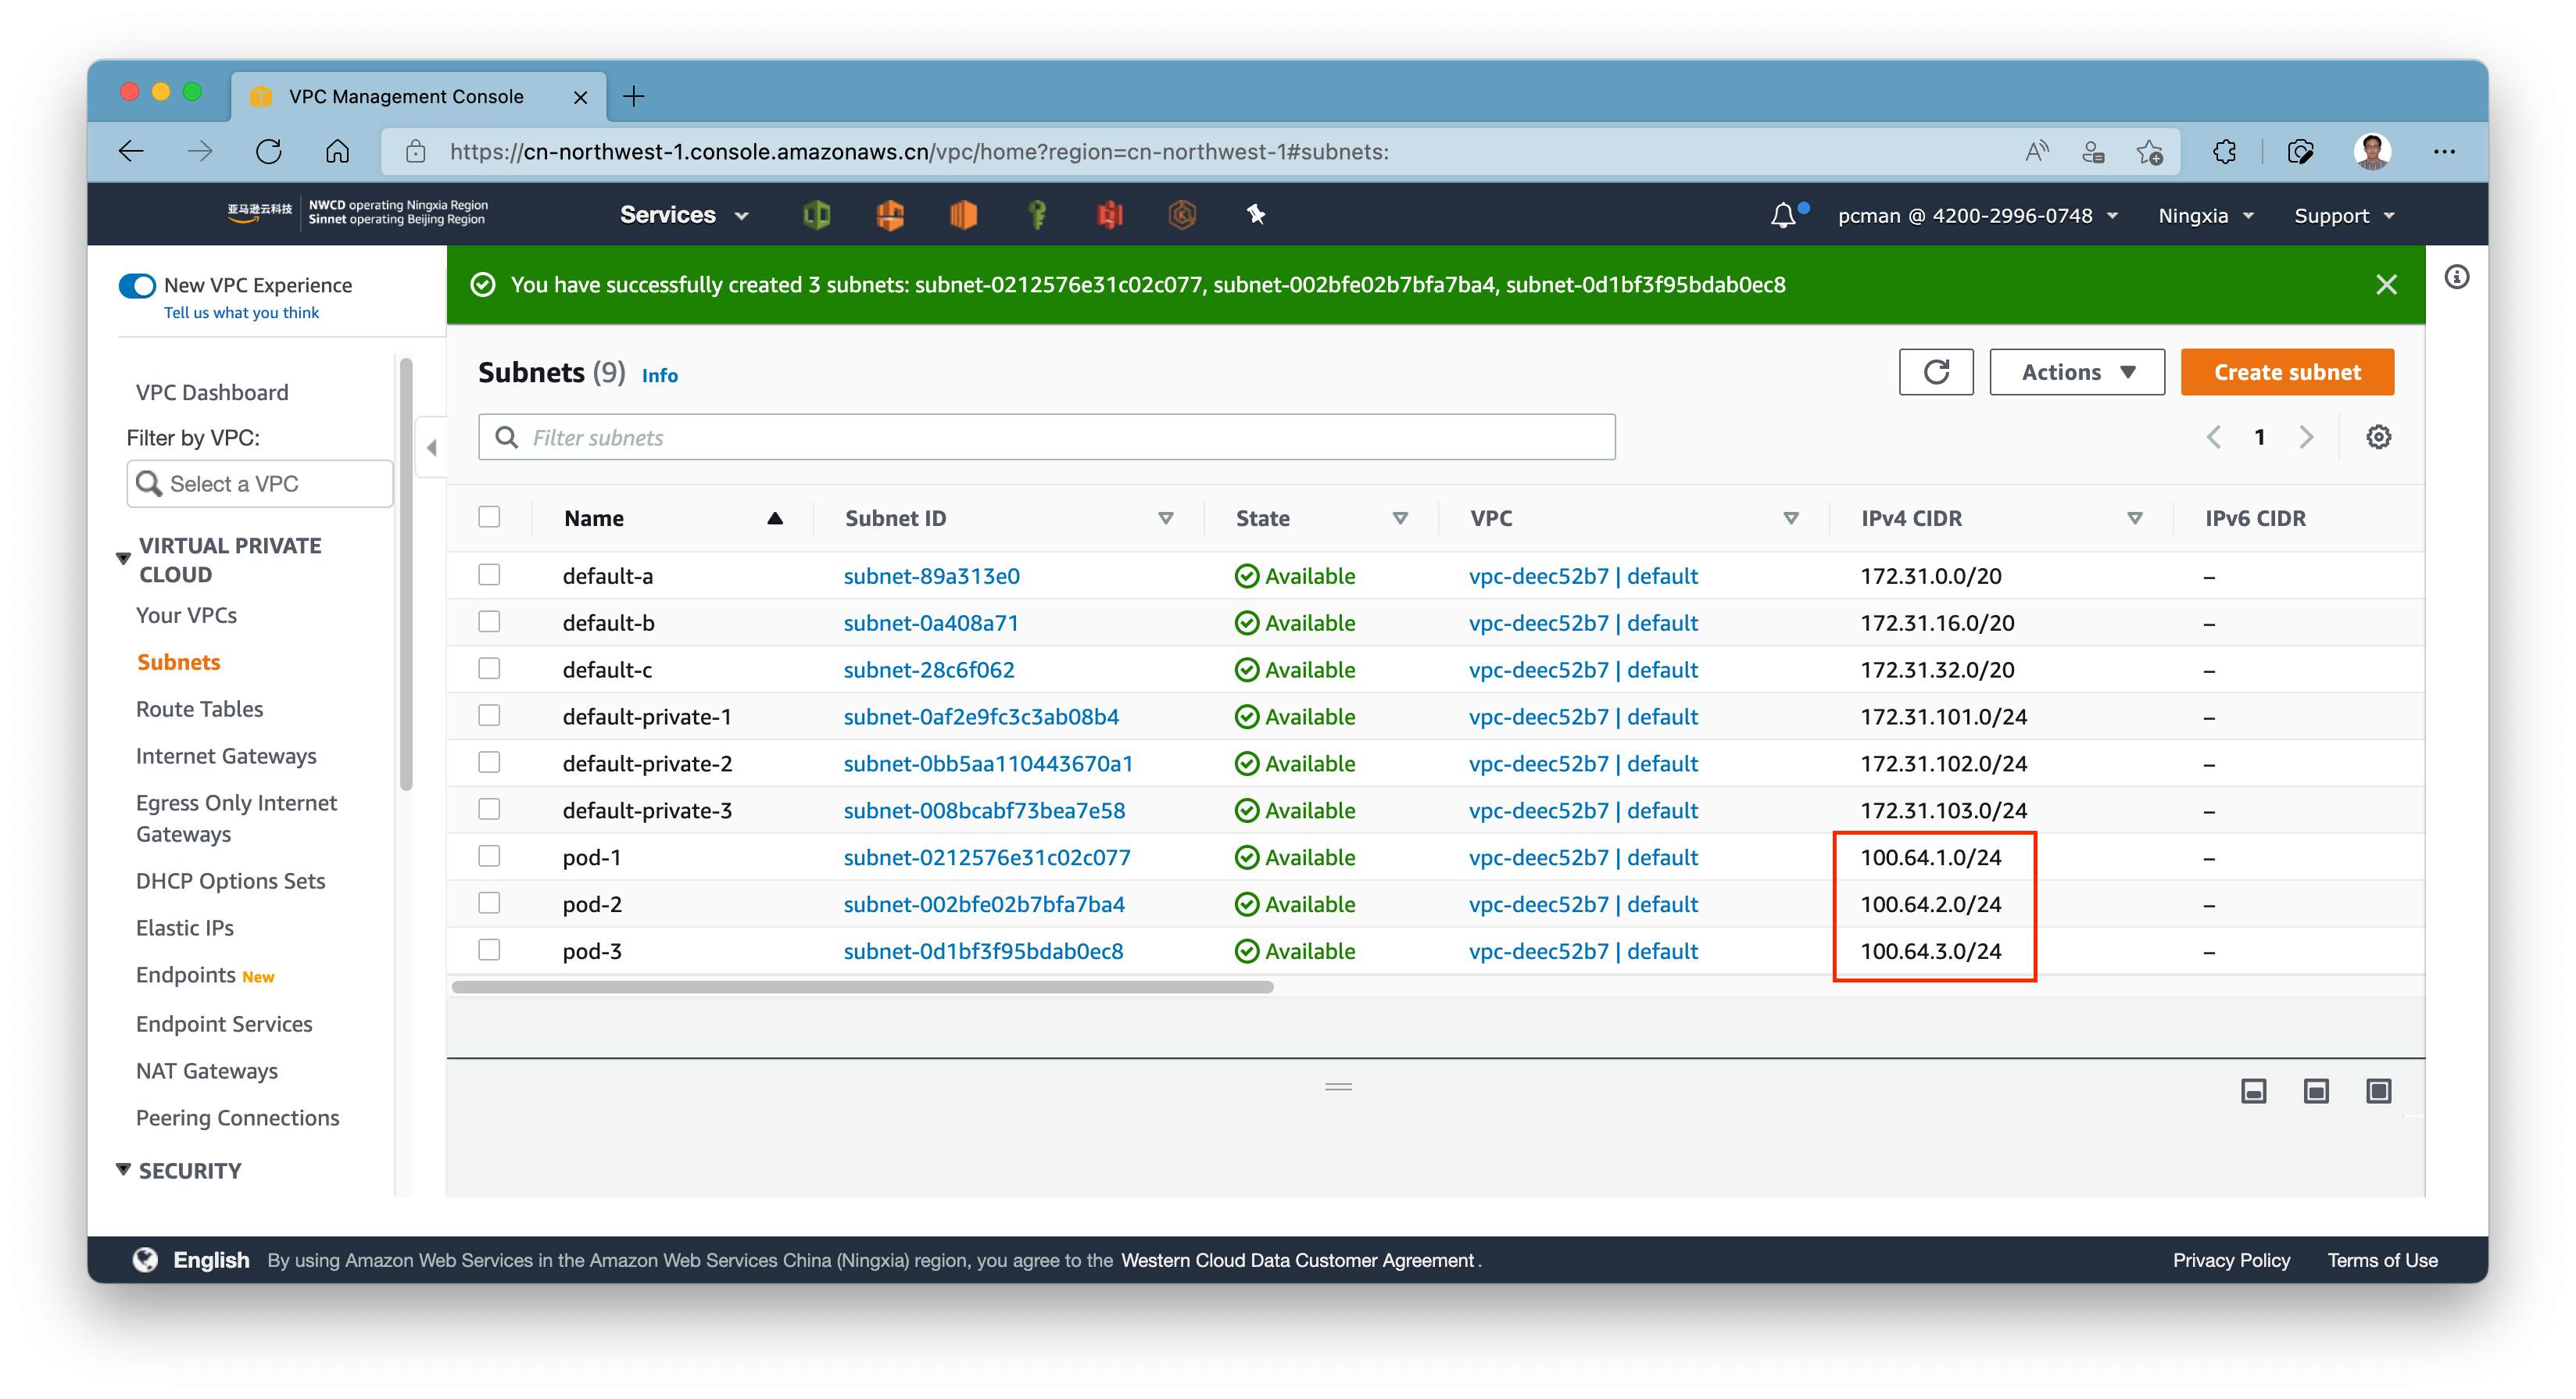
进入创建子网界面,选择对应的VPC,创建新的子网,并使用刚才新添加的IP地址段。例如本例中100.64.0.0/16被添加到VPC中,那么子网可采用100.64.1.0/24、100.64.2.0/24、100.64.3.0/24分别对应三个AZ。
如此分别为3个AZ都创建好对应的Pod使用的子网。如下截图。
操作完成。
3、为新增加的子网配置路由表
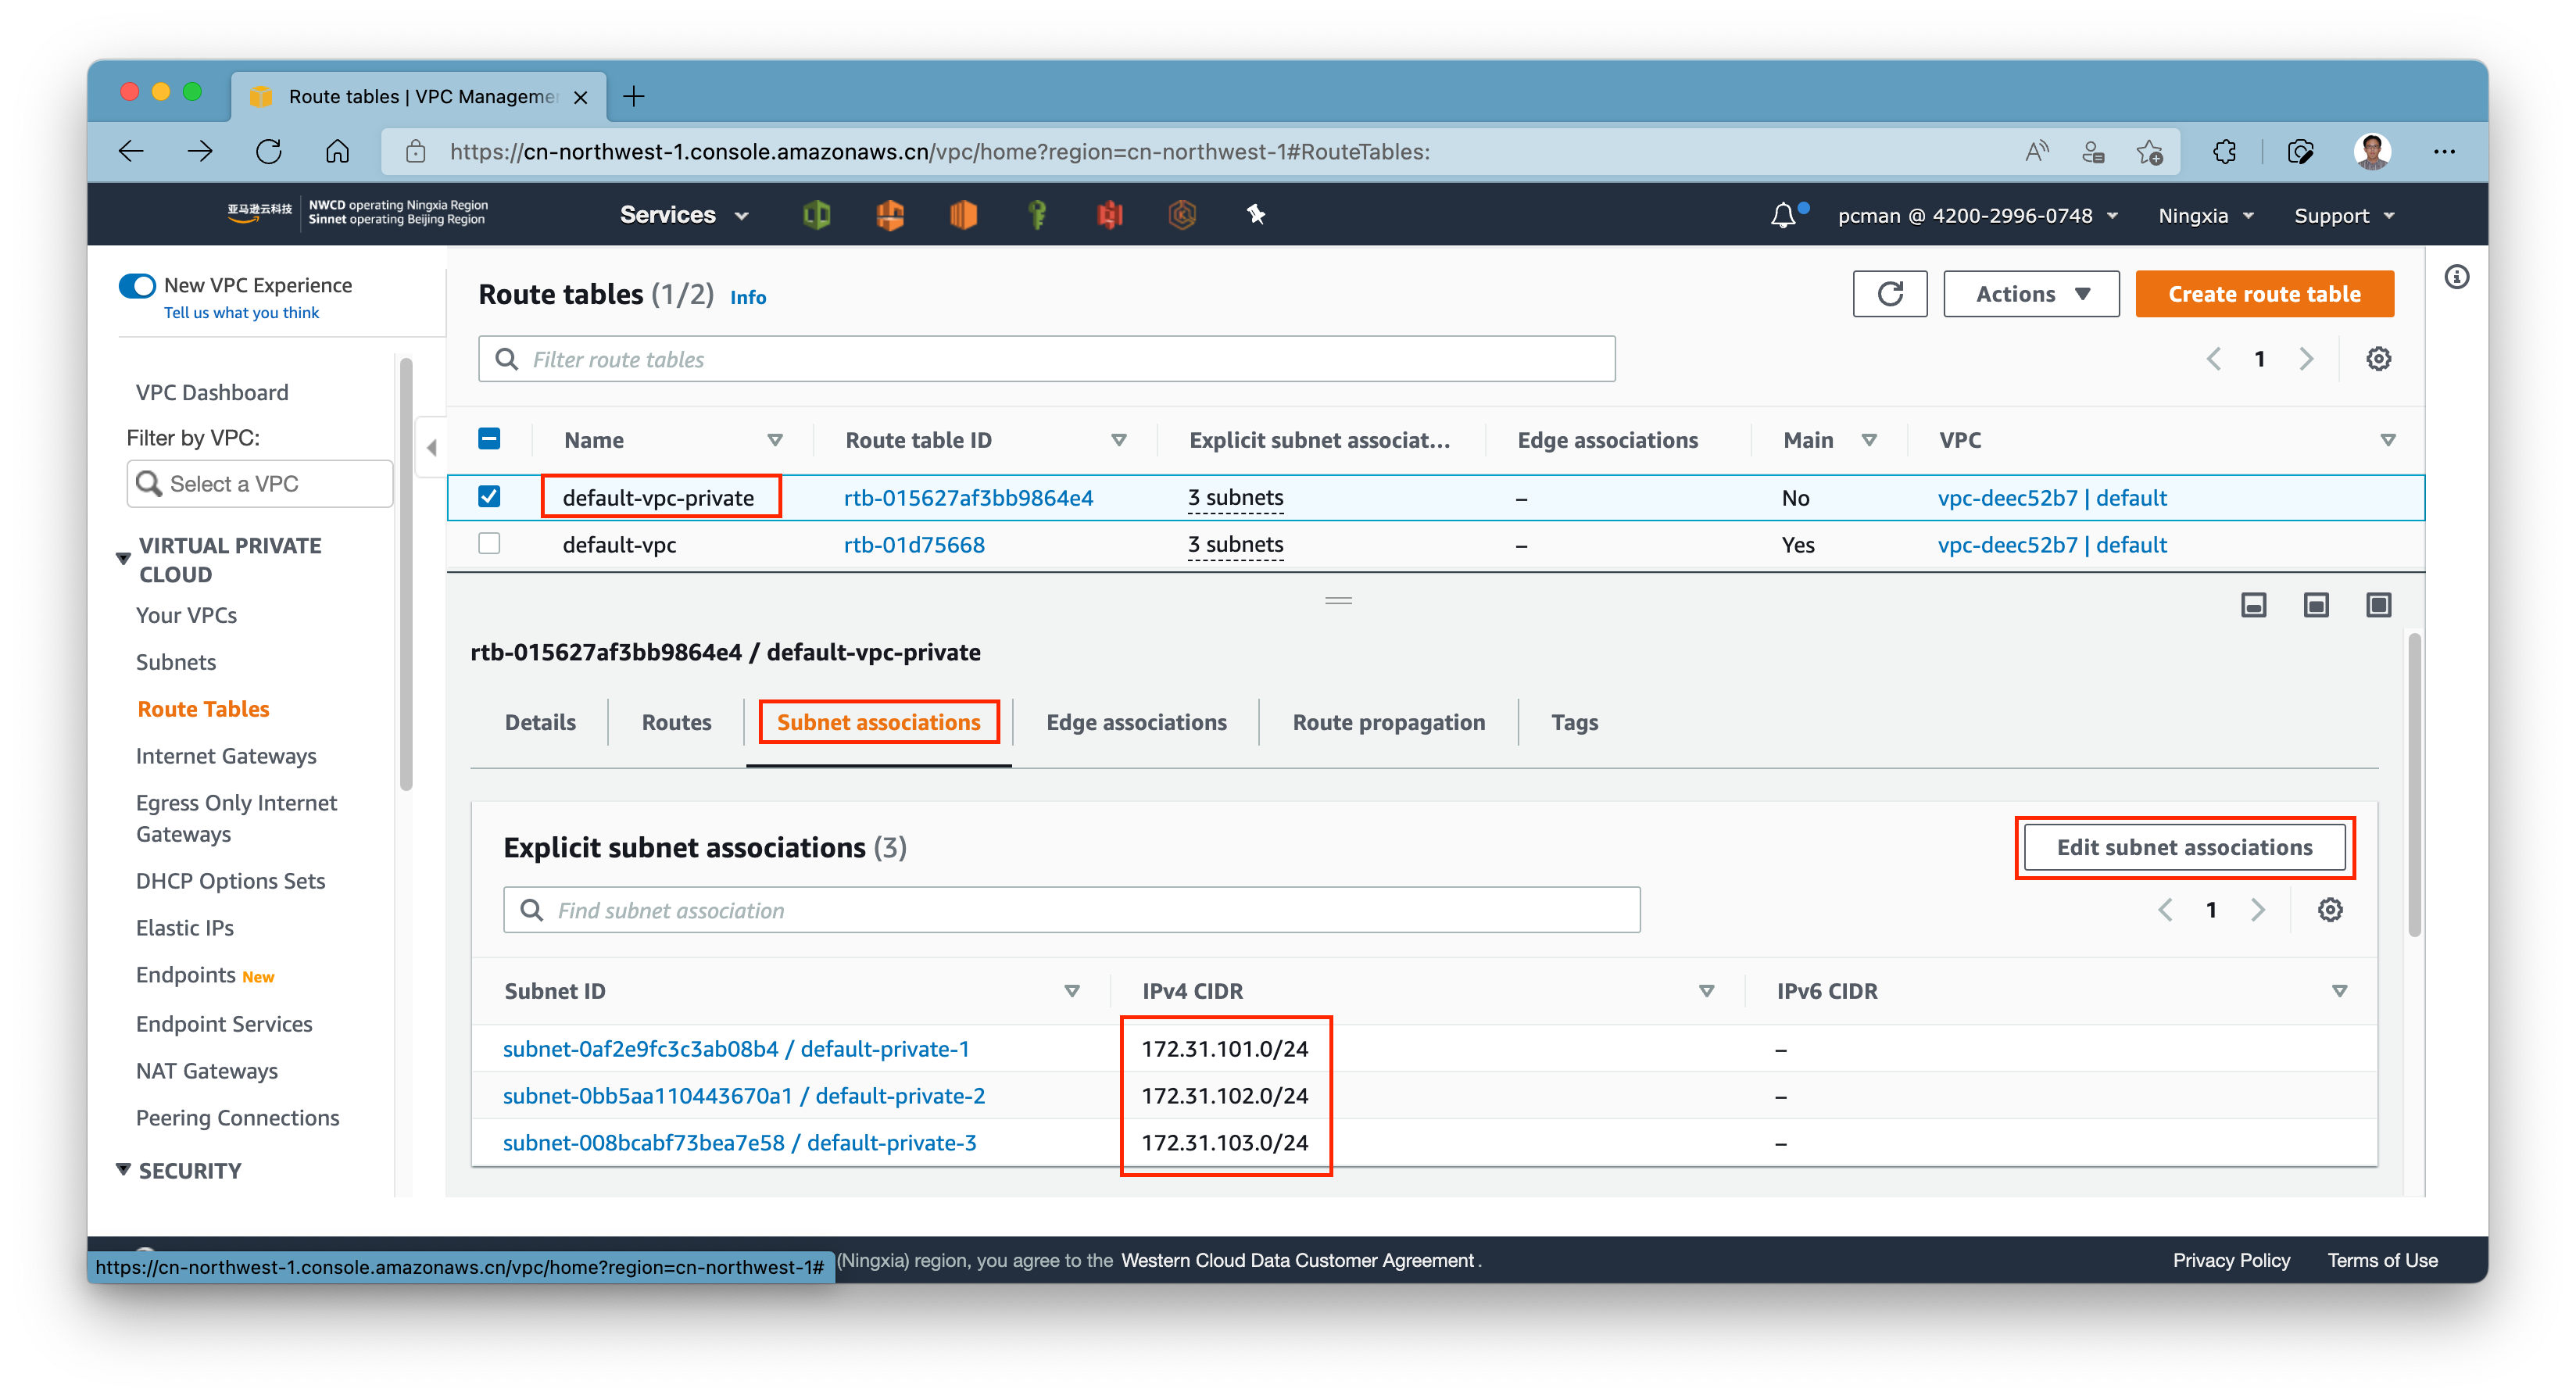
新创建好的子网会绑定到VPC默认路由表,因此还需要将新创建的子网绑定到和Node节点同一个路由表。进入路由表界面,查看Node所在的private subnet的路由表,可以看到当前只关联了三个Node子网。点击编辑按钮。如下截图。
将新创建的Pod子网关联到Node所在的Private子网的路由表上。如下截图。
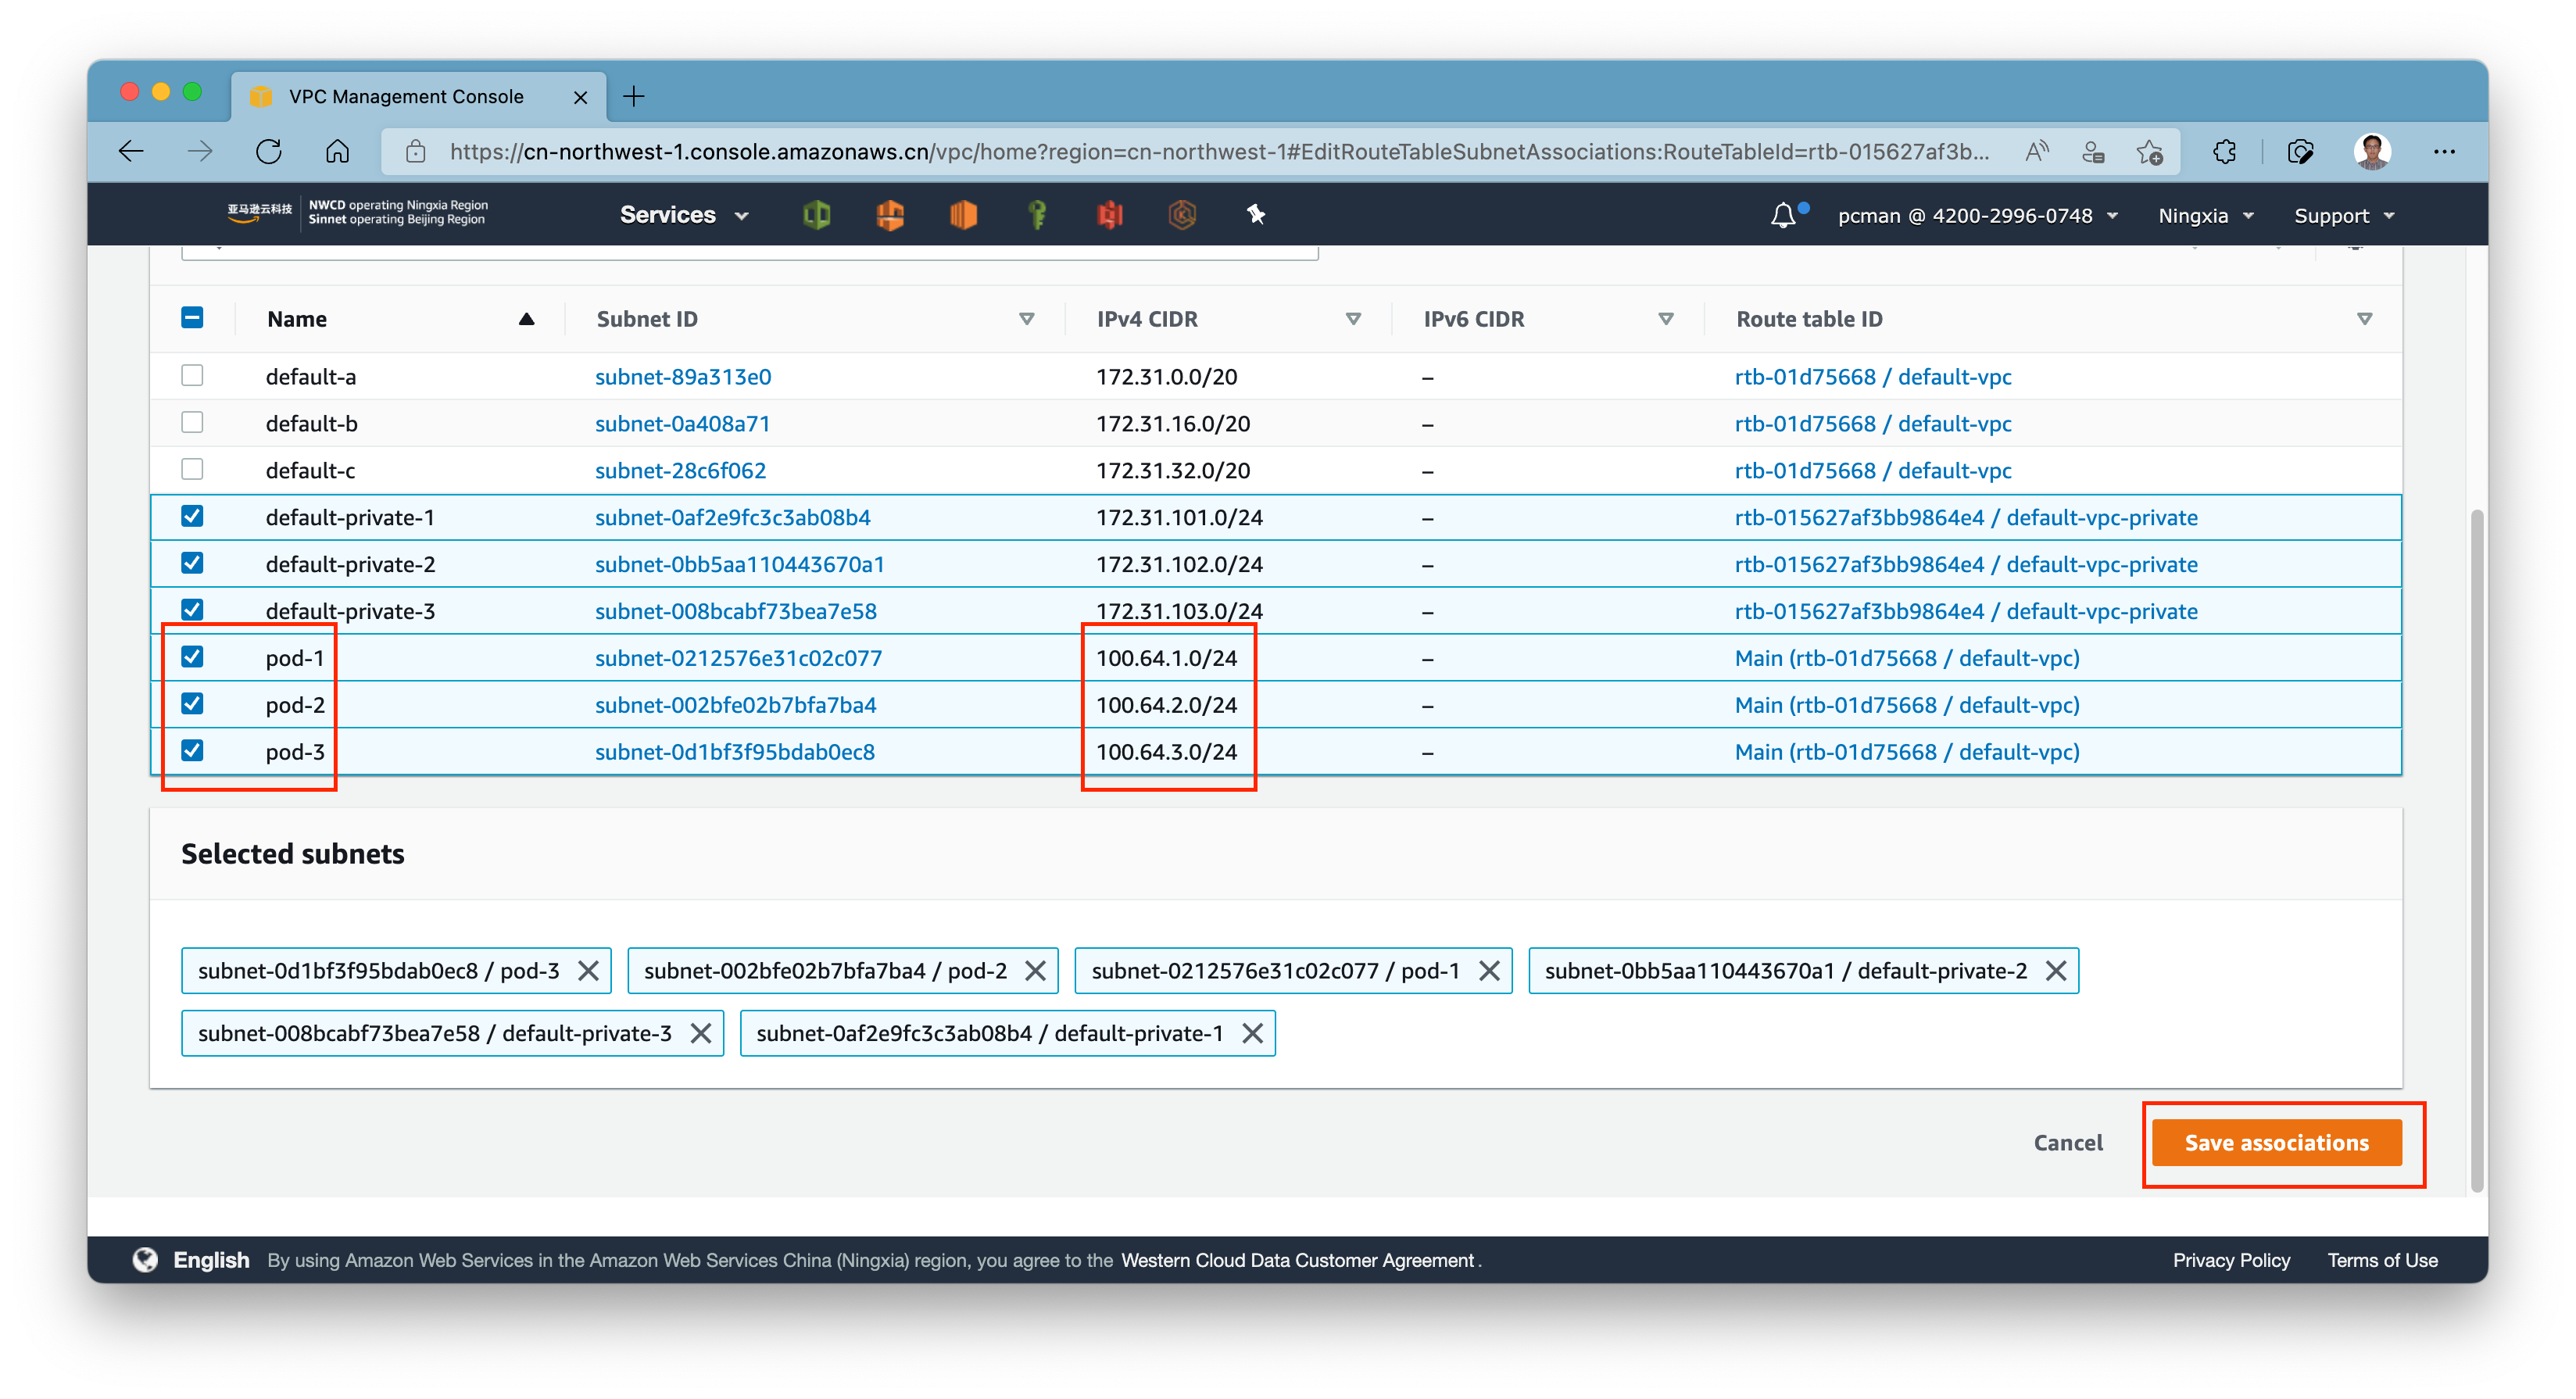
注意:不少VPC采用的是每个可用区一张独立私有路由表的布局,例如由eksctl自动创建的VPC就属于这种情况,其路由表名称形如PrivateRouteTableAPSOUTHEAST1A。在这种布局下,Pod子网必须关联到同一可用区的那张私有路由表,而不能任选一张,否则Pod的出站流量会被送往其他可用区的NAT Gateway,既产生跨可用区流量费用,也在该可用区故障时形成不必要的依赖。
添加子网完成后,确认下Node所在的子网和Pod所在的子网,所对应的路由表的下一跳是NAT Gateway。这是因为这两个子网都是私有子网,没有Elastic IP,因此默认网关下一跳都必须是NAT Gateway。如下截图。
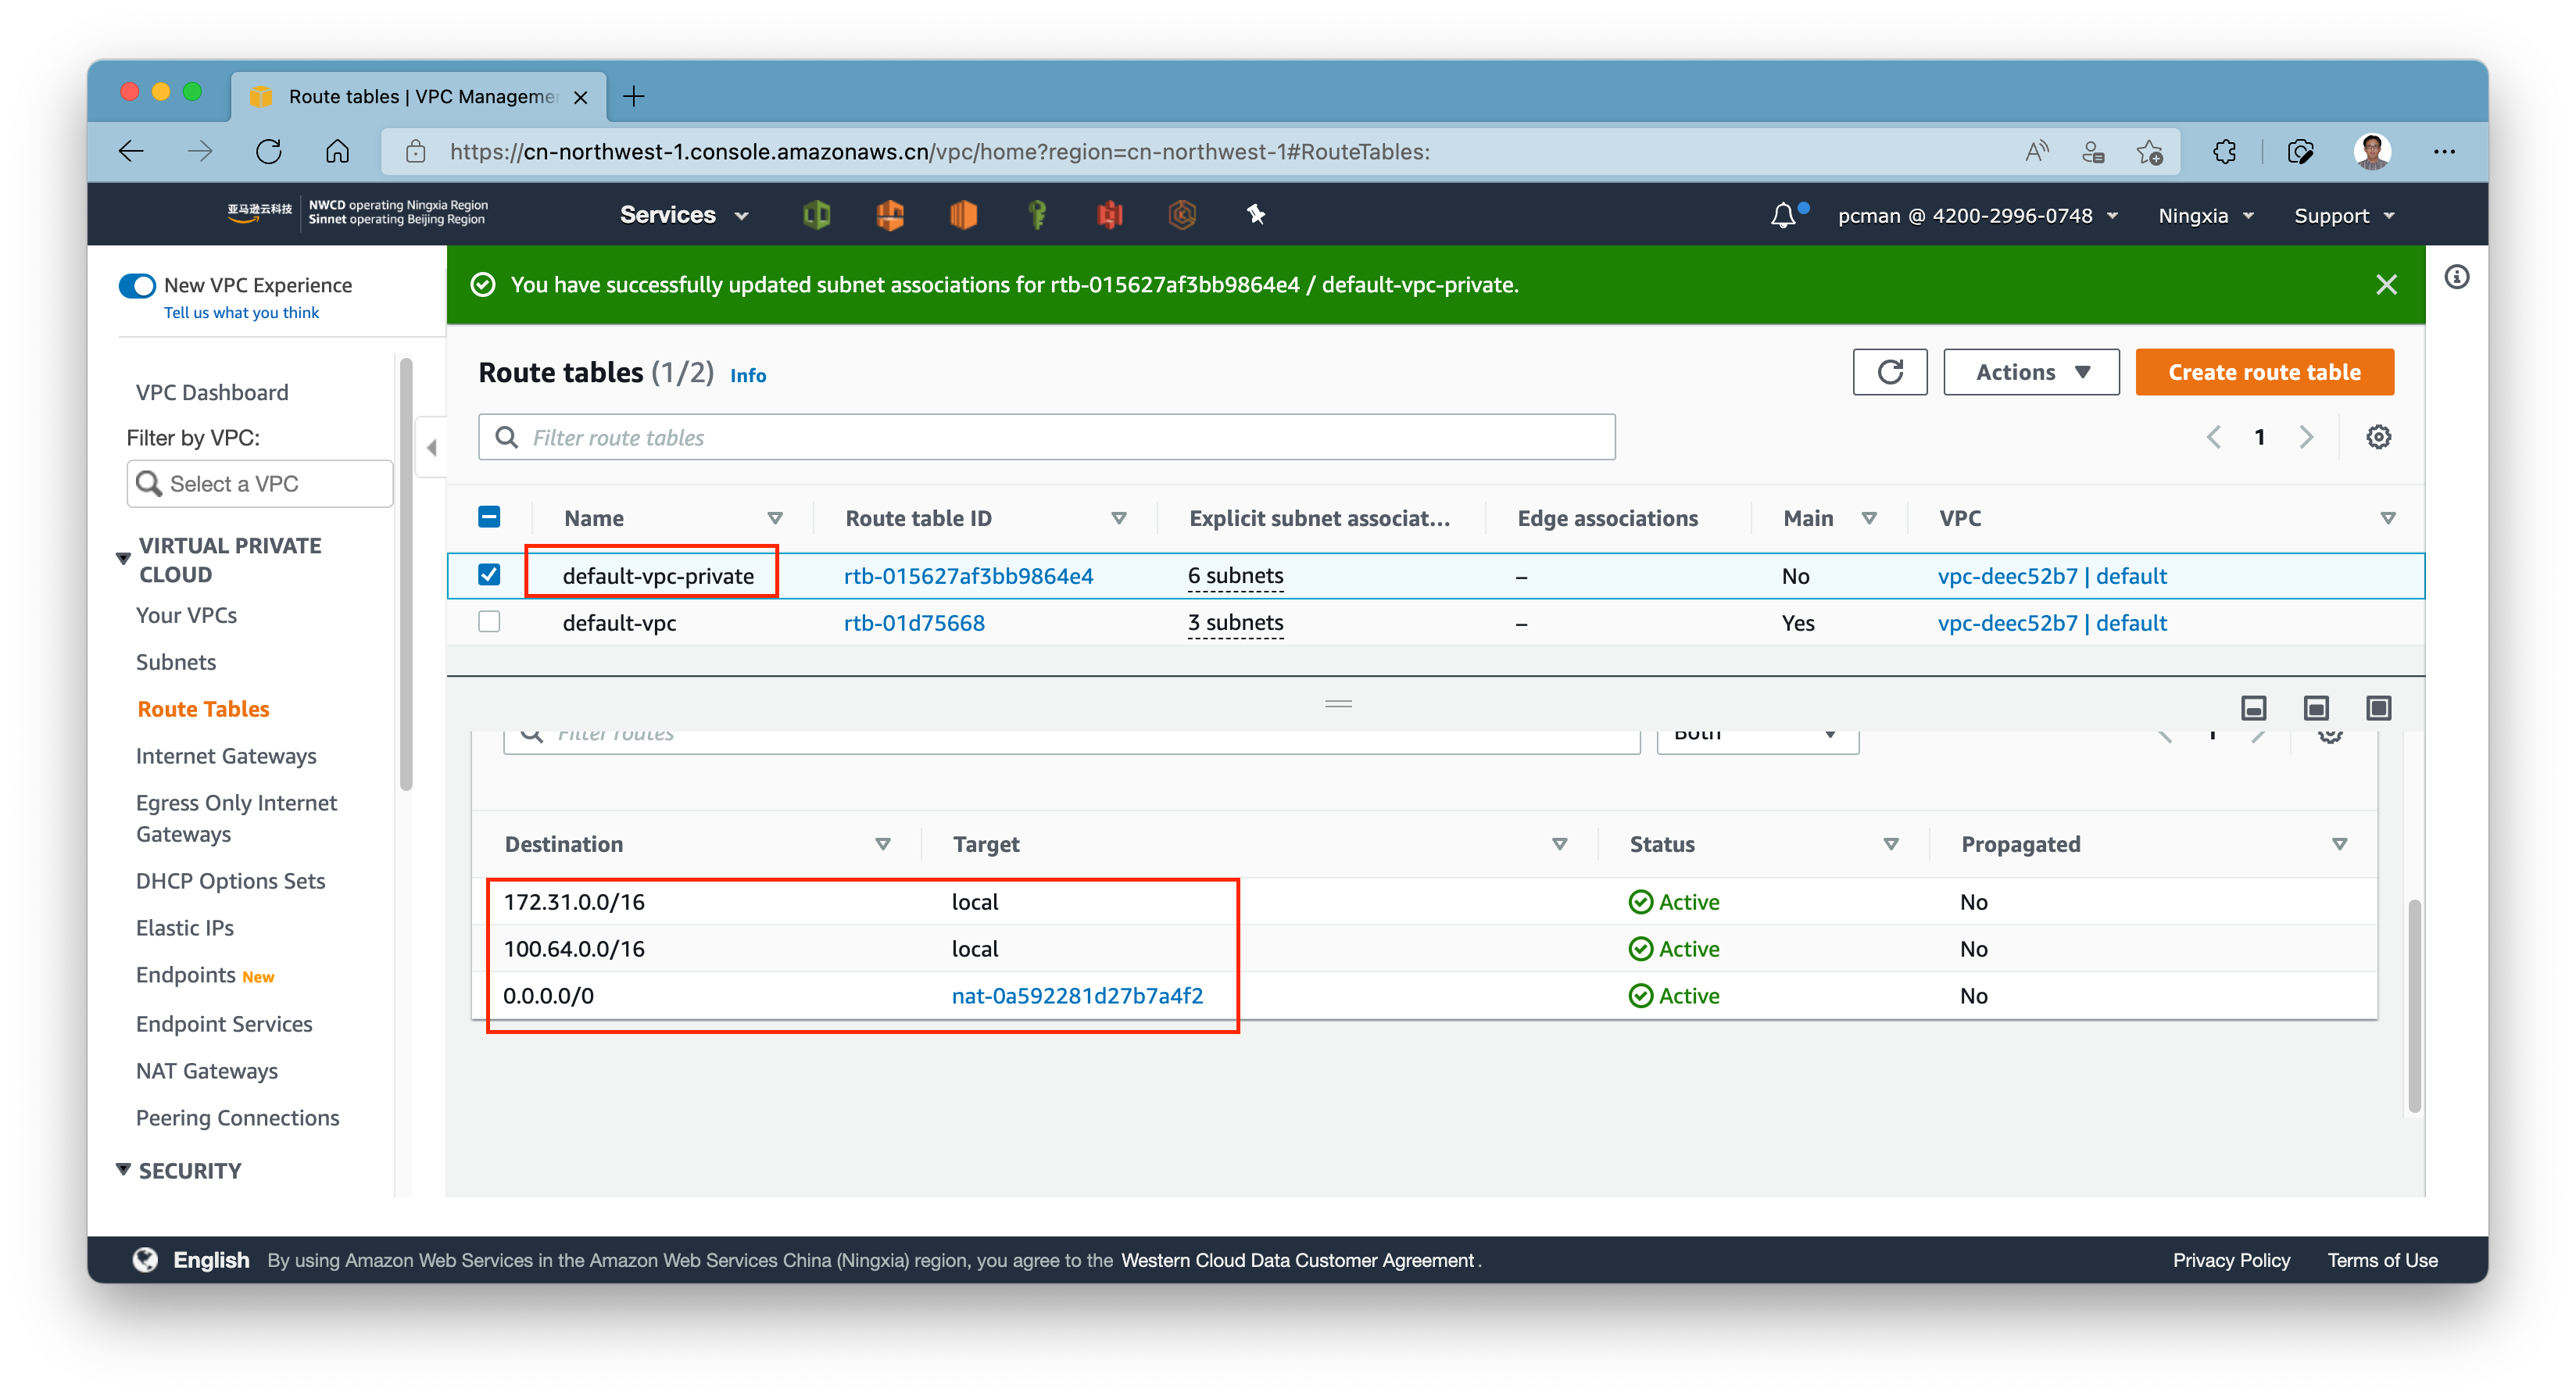
备注:如果您使用了Gateway Load Balancer做的集中网络流量检测方案,那么这里的默认网关下一跳应该是TGW。如果您没有使用Gateway Load Balancer,默认下一跳都是NAT Gateway。
4、为要使用ELB的子网打标签
(1)使用Internet-facing ELB,面向公网提供服务
找到当前的VPC,找到有EIP和NAT Gateway的Public Subnet,为其添加标签(多个AZ需要同时添加):
- 标签名称:
kubernetes.io/role/elb,值:1
如果之前标签已经存在,请跳过这一步。
(2)使用Internal ELB,面向Private内部子网提供服务
在创建私有ELB时候,可选的任意子网创建,可以选择一个独立的私有子网部署ELB,也可以选择Node所在子网,也可以选择Pod所在子网。
本文以使用Node所在子网为例。在VPC界面上,找到Node使用的私有子网,为其添加标签(多个AZ需要同时添加):
- 标签名称:
kubernetes.io/role/internal-elb,值:1
接下来请重复以上工作,每个AZ的子网都实施相同的配置,注意第一项标签值都是1。至此VPC配置完毕。
三、创建并配置EKS集群
1、创建一个默认EKS集群
首先构建配置文件,替换其中的子网ID为Node所在的子网ID。
注意:本配置文件已适配EKS 1.36版本,metadata.version字段设置为"1.36",同时iam.withAddonPolicies代码块中已移除albIngress: true一行,其功能由awsLoadBalancerController取代。有关EKS 1.36版本其他行为变更的说明,请参考实验一。
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig

metadata:
  name: eksworkshop
  region: ap-southeast-1
  version: "1.36"

vpc:
  clusterEndpoints:
    publicAccess:  true
    privateAccess: true
  subnets:
    private:
      ap-southeast-1a: { id: subnet-04a7c6e7e1589c953 }
      ap-southeast-1b: { id: subnet-031022a6aab9b9e70 }
      ap-southeast-1c: { id: subnet-0eaf9054aa6daa68e }

kubernetesNetworkConfig:
  serviceIPv4CIDR: 10.50.0.0/24

managedNodeGroups:
  - name: managed-ng
    labels:
      Name: managed-ng
    instanceType: t3.2xlarge
    minSize: 3
    desiredCapacity: 3
    maxSize: 6
    privateNetworking: true
    subnets:
      - subnet-04a7c6e7e1589c953
      - subnet-031022a6aab9b9e70
      - subnet-0eaf9054aa6daa68e
    volumeType: gp3
    volumeSize: 100
    tags:
      nodegroup-name: managed-ng
    iam:
      withAddonPolicies:
        imageBuilder: true
        autoScaler: true
        externalDNS: true
        certManager: true
        efs: true
        ebs: true
        fsx: true
        awsLoadBalancerController: true
        xRay: true
        cloudWatch: true

cloudWatch:
  clusterLogging:
    enableTypes: ["api", "audit", "authenticator", "controllerManager", "scheduler"]
    logRetentionInDays: 30
将以上内容保存为eks-in-private-subnet.yaml,然后运行如下命令启动集群。
eksctl create cluster -f eks-in-private-subnet.yaml
2、部署AWS Load Balancer Controller
有关详细部署Load Balancer Controllerd的说明请参考前文的实验。
3、部署CloudWatch Container Insight
部署CloudWatch Container Insight的方法与此前方法相同。可参考这篇文档。
四、修改EKS的网络参数为Pod指定单独子网
注意:在修改本参数之后,必须重新创建新的Nodegroup才可以生效
1、调整aws-vpc-cni的参数分别设置Node子网和Pod子网
自定义网络需要在VPC CNI上设置两个环境变量:AWS_VPC_K8S_CNI_CUSTOM_NETWORK_CFG用于启用自定义网络,ENI_CONFIG_LABEL_DEF用于指定VPC CNI依据哪一个节点标签来选取ENIConfig。托管节点组会自动为每个节点打上topology.kubernetes.io/zone标签,其值为该节点所在可用区的名称,因此以该标签作为选取依据最为直接。
注意:这两个环境变量必须通过aws eks update-addon命令写入vpc-cni这个托管Addon的配置项,而不能使用kubectl set env daemonset aws-node命令。原因是EKS 1.36版本下vpc-cni已经是由EKS托管的Addon,直接修改DaemonSet属于集群内的带外改动,Addon在下一次版本更新时会以自身配置重新覆盖DaemonSet,导致自定义网络被静默关闭。这一失效方式没有任何告警,只会表现为新建节点上的Pod重新从Node子网取得IP地址。
首先获取集群安全组的ID,该安全组将被赋予Pod所使用的二级网络接口。执行如下命令:
aws eks describe-cluster --name eksworkshop --region ap-southeast-1 --query cluster.resourcesVpcConfig.clusterSecurityGroupId --output text
返回结果如下。
sg-0bc05dc2178acff1d
接下来进入AWS控制台,从子网界面查看子网信息,确定Pod所在子网,获得可用区ID和子网ID。将三个Pod子网的信息分别复制下来。如下截图。
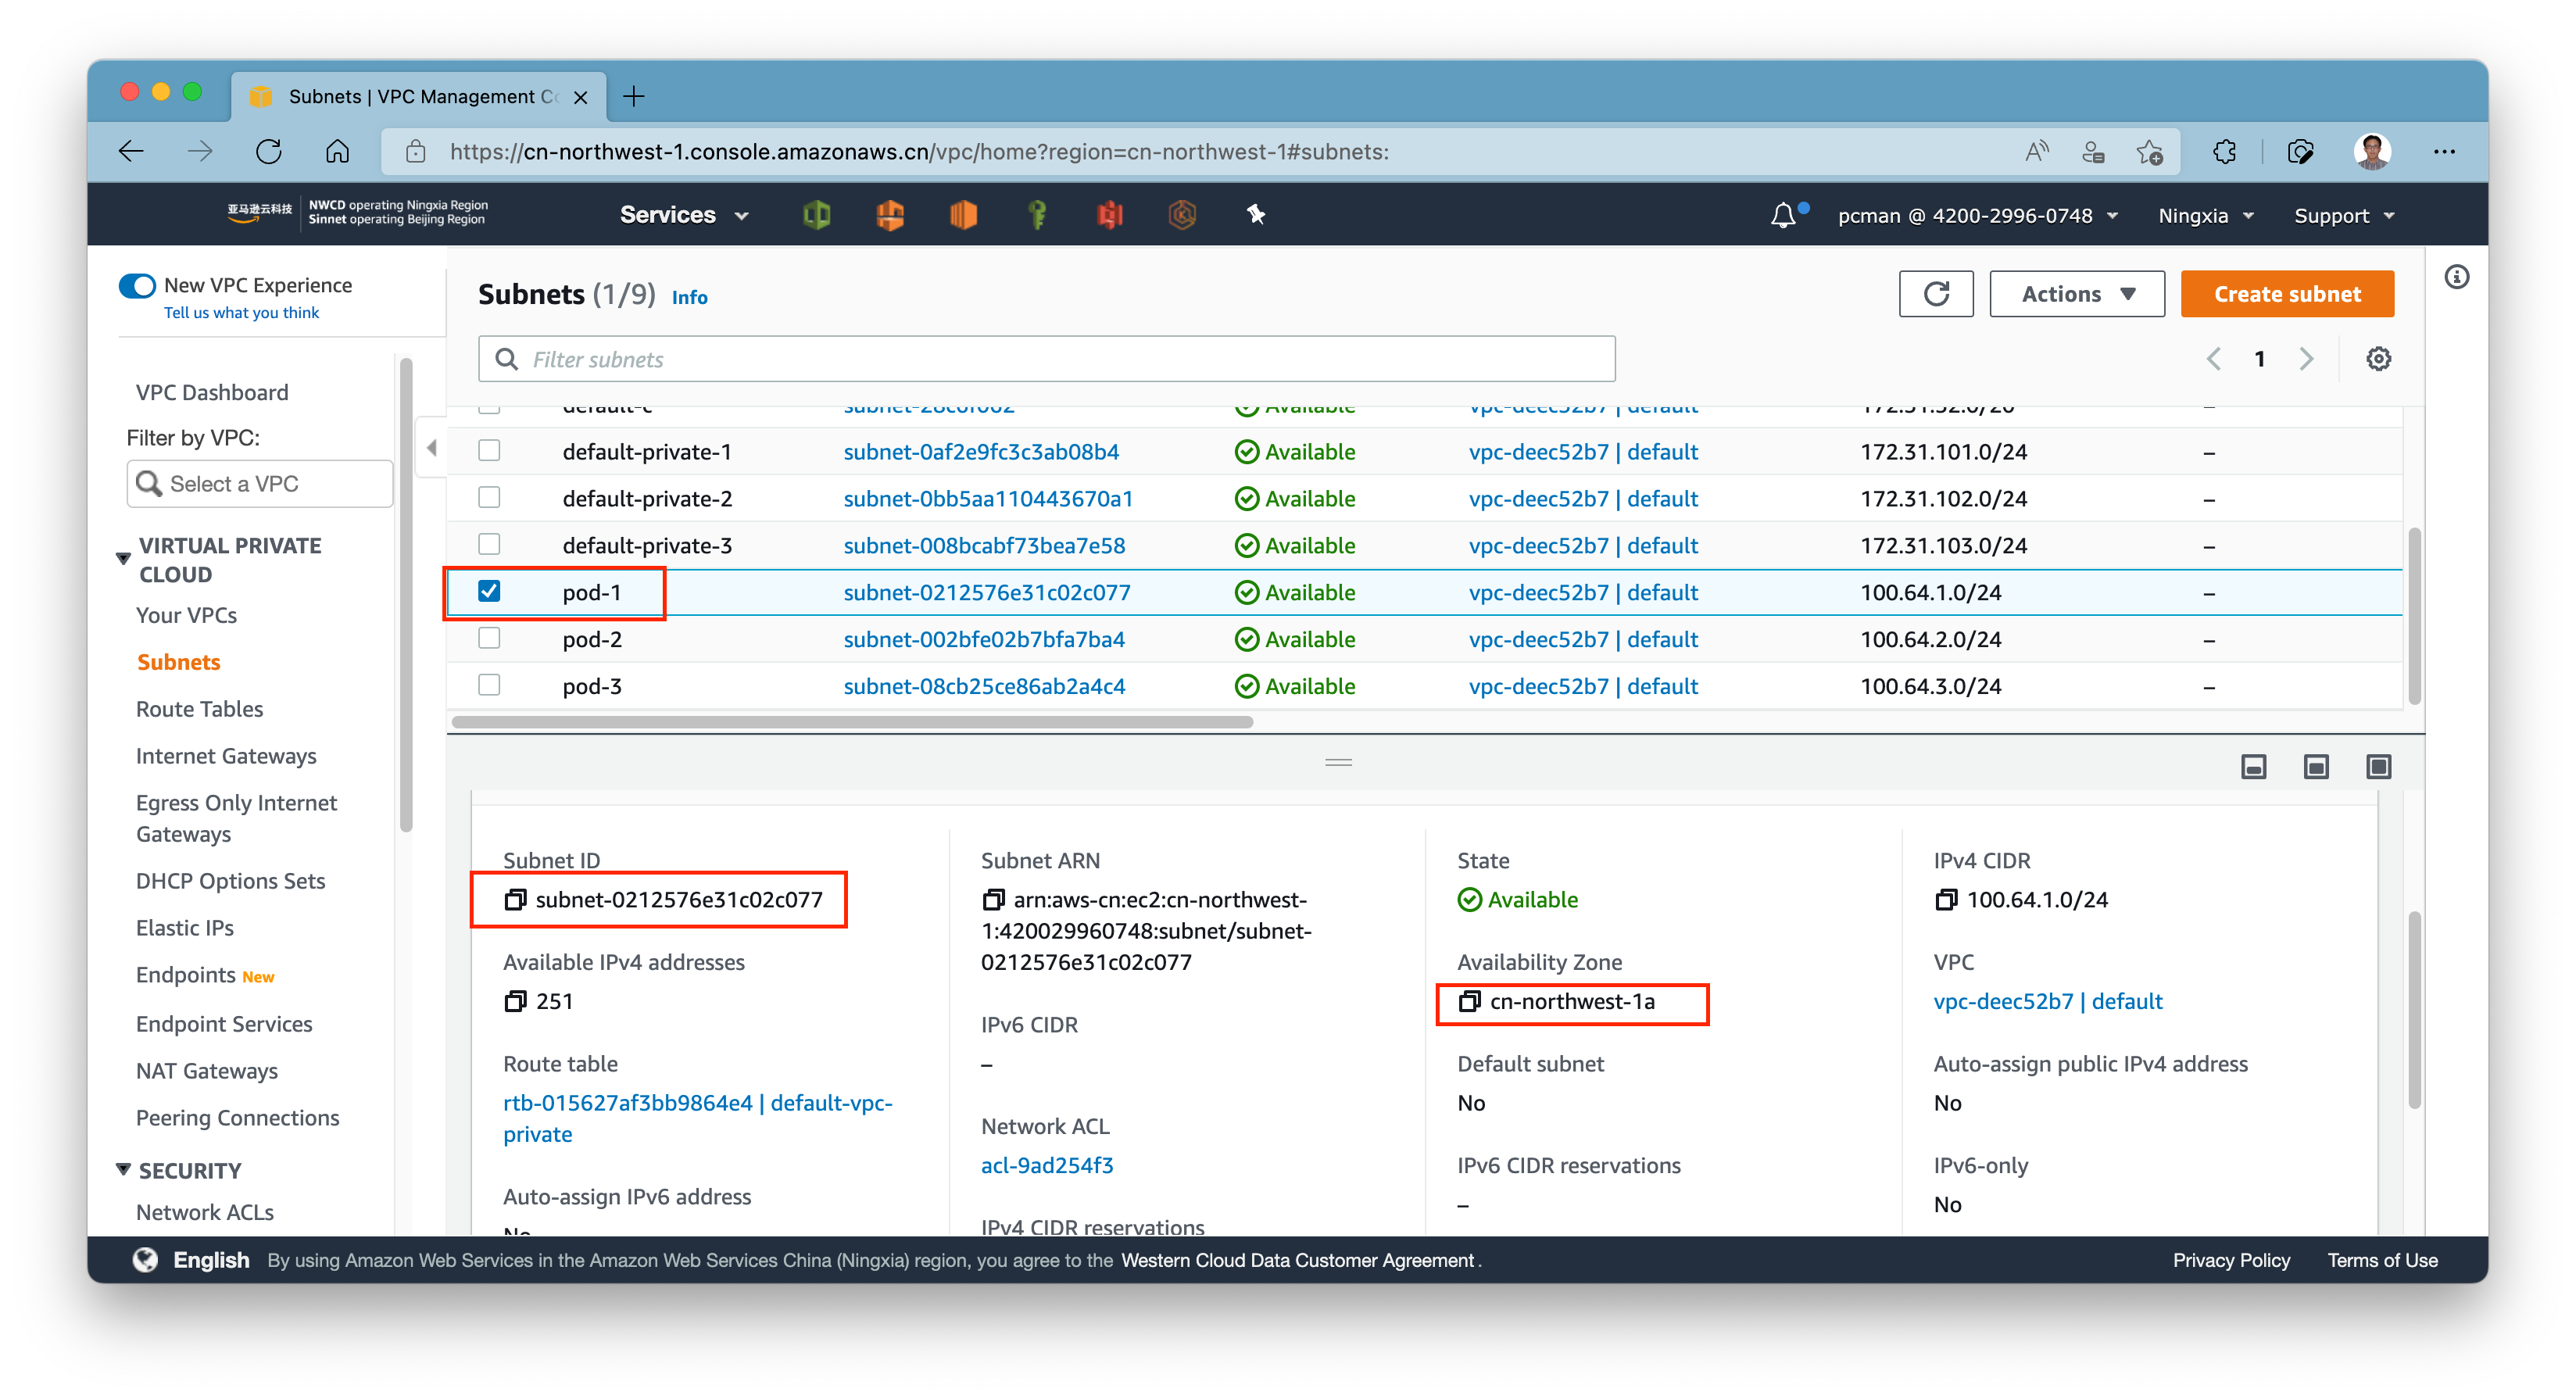
用文本编辑器编辑如下文件,替换其中的可用区名称、子网ID为Pod所在子网的对应值,安全组ID替换为上一步获取的集群安全组ID,然后保存为eniconfig.yaml文件。
apiVersion: crd.k8s.amazonaws.com/v1alpha1
kind: ENIConfig
metadata:
  name: ap-southeast-1a
spec:
  subnet: subnet-0691037d70aac39da
  securityGroups:
    - sg-0bc05dc2178acff1d
---
apiVersion: crd.k8s.amazonaws.com/v1alpha1
kind: ENIConfig
metadata:
  name: ap-southeast-1b
spec:
  subnet: subnet-096d7481a653e3f47
  securityGroups:
    - sg-0bc05dc2178acff1d
---
apiVersion: crd.k8s.amazonaws.com/v1alpha1
kind: ENIConfig
metadata:
  name: ap-southeast-1c
spec:
  subnet: subnet-0db55d7fb02249825
  securityGroups:
    - sg-0bc05dc2178acff1d
注意:metadata.name的取值必须与ENI_CONFIG_LABEL_DEF所指向的节点标签值完全一致。由于本文使用topology.kubernetes.io/zone标签,因此这里必须使用可用区名称(例如ap-southeast-1a),而不能使用可用区ID(例如apse1-az1)。
注意:securityGroups字段可以省略,省略时VPC CNI会为二级网络接口沿用节点主网络接口上的安全组。这里显式指定集群安全组,目的是让Pod与Node的安全组关系在配置中可见。需要注意的是,Pod所使用的子网和安全组必须与节点处于同一个VPC内,跨VPC不被支持。
将以上配置文件保存为eniconfig.yaml文件。然后执行如下命令:
kubectl apply -f eniconfig.yaml
返回结果如下。
eniconfig.crd.k8s.amazonaws.com/ap-southeast-1a created
eniconfig.crd.k8s.amazonaws.com/ap-southeast-1b created
eniconfig.crd.k8s.amazonaws.com/ap-southeast-1c created
执行命令kubectl get ENIConfigs验证配置是否成功。返回结果如下则表示设置成功。
NAME              AGE
ap-southeast-1a   2s
ap-southeast-1b   2s
ap-southeast-1c   1s
接下来通过更新vpc-cni托管Addon的配置项,一次性写入上述两个环境变量。执行如下命令:
aws eks update-addon --cluster-name eksworkshop --region ap-southeast-1 \
  --addon-name vpc-cni \
  --configuration-values '{"env":{"AWS_VPC_K8S_CNI_CUSTOM_NETWORK_CFG":"true","ENI_CONFIG_LABEL_DEF":"topology.kubernetes.io/zone"}}'
返回结果如下,其中status为InProgress表示Addon已经开始更新。
{
    "update": {
        "id": "d85c72e5-617a-30d0-9862-17031a15ddd7",
        "status": "InProgress",
        "type": "AddonUpdate",
        "params": [
            {
                "type": "ConfigurationValues",
                "value": "{\"env\":{\"AWS_VPC_K8S_CNI_CUSTOM_NETWORK_CFG\":\"true\",\"ENI_CONFIG_LABEL_DEF\":\"topology.kubernetes.io/zone\"}}"
            }
        ],
        "createdAt": "2026-09-19T21:39:09.927000+08:00",
        "errors": []
    }
}
Addon更新会触发aws-node这个DaemonSet的滚动重启,通常在1分钟内完成。执行如下命令等待其恢复:
kubectl rollout status daemonset aws-node -n kube-system
返回结果如下。
daemon set "aws-node" successfully rolled out
为了确认上述配置已经生效,执行如下命令:
kubectl describe daemonset aws-node -n kube-system | grep -E "AWS_VPC_K8S_CNI_CUSTOM_NETWORK_CFG|ENI_CONFIG_LABEL_DEF"
返回如下结果表示设置成功。
      AWS_VPC_K8S_CNI_CUSTOM_NETWORK_CFG:     true
      ENI_CONFIG_LABEL_DEF:                   topology.kubernetes.io/zone
同时可以执行如下命令确认该配置已经持久化到Addon本身,而非仅存在于集群内的DaemonSet。
aws eks describe-addon --cluster-name eksworkshop --region ap-southeast-1 --addon-name vpc-cni --query addon.configurationValues --output text
返回结果如下。
{"env":{"AWS_VPC_K8S_CNI_CUSTOM_NETWORK_CFG":"true","ENI_CONFIG_LABEL_DEF":"topology.kubernetes.io/zone"}}
2、使用Node子网创建新的Nodegroup节点组
注意:修改了EKS网络参数后,必须重新创建新的Nodegroup节点组。自定义网络只在节点引导阶段被读取,已经运行中的节点不会重新申请二级网络接口,其上原有的Pod也不会自动迁移到新分配的子网。
构建如下内容,保存为new-subnet-for-pod.yaml文件。注意这里建议使用与原节点组相同处理器架构的实例类型,这样便于Pod可以自动漂移过去。
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig

metadata:
  name: eksworkshop
  region: ap-southeast-1
  version: "1.36"

managedNodeGroups:
  - name: podsubnet-ng
    labels:
      Name: podsubnet-ng
    instanceType: t3.2xlarge
    minSize: 3
    desiredCapacity: 3
    maxSize: 6
    volumeType: gp3
    volumeSize: 100
    volumeIOPS: 3000
    volumeThroughput: 125
    tags:
      nodegroup-name: podsubnet-ng
    iam:
      withAddonPolicies:
        imageBuilder: true
        autoScaler: true
        externalDNS: true
        certManager: true
        efs: true
        ebs: true
        fsx: true
        awsLoadBalancerController: true
        xRay: true
        cloudWatch: true
备注:这里的节点组名称使用podsubnet-ng,目的是与实验三中创建的newng节点组区分开,避免在同一个集群上连续做完多个实验之后出现名称冲突。读者可自行替换为其他名称,但需与后续命令保持一致。
保存配置完毕后,执行如下命令生效:
eksctl create nodegroup -f new-subnet-for-pod.yaml
备注:启用自定义网络之后,节点主网络接口不再向Pod分配IP地址,因此单节点可运行的Pod数量会低于该实例类型的默认值。托管节点组在创建时会读取aws-node这个DaemonSet的实际配置并自动计算出下调后的max-pods值,因此只要遵循本文的顺序,即先完成上一节的CNI配置再创建节点组,就不需要手工指定该参数。反之,若先创建节点组再启用自定义网络,节点上的max-pods会偏高,出现调度成功但Pod长时间停留在ContainerCreating状态并报告IP地址分配失败的情况。
节点组创建完成后,可执行如下命令确认新节点上的max-pods已经下调:
kubectl get node -l Name=podsubnet-ng -o custom-columns=NAME:.metadata.name,MAXPODS:.status.allocatable.pods
返回结果如下。t3.2xlarge实例类型默认可运行58个Pod,启用自定义网络后按(4个网络接口 - 1) x (15个IP地址 - 1) + 2计算,下调为44个。
NAME                                                MAXPODS
ip-192-168-30-108.ap-southeast-1.compute.internal   44
ip-192-168-54-190.ap-southeast-1.compute.internal   44
ip-192-168-69-155.ap-southeast-1.compute.internal   44
此外还可以从AWS侧确认二级网络接口确实建立在Pod子网中。执行如下命令,将子网ID替换为三个Pod子网的ID:
aws ec2 describe-network-interfaces --region ap-southeast-1 \
  --filters Name=subnet-id,Values=subnet-00cdfbc3bc514fece,subnet-014ed3ae44c6f2345,subnet-07b15b677debe73a9 \
  --query 'NetworkInterfaces[].{ENI:NetworkInterfaceId,Subnet:SubnetId,PrivIP:PrivateIpAddress,Desc:Description}' --output table
返回结果如下,其中Desc列的aws-K8S-前缀加实例ID,表明这些网络接口由VPC CNI创建并挂载到对应的节点实例上。随着节点上Pod数量增加,VPC CNI会按需在同一子网内追加更多二级网络接口,因此同一个实例ID可能对应多行。
------------------------------------------------------------------------------------------------------
|                                      DescribeNetworkInterfaces                                     |
+-----------------------------+-------------------------+---------------+----------------------------+
|            Desc             |           ENI           |    PrivIP     |          Subnet            |
+-----------------------------+-------------------------+---------------+----------------------------+
|  aws-K8S-i-00c1b0a868824b4b2|  eni-0d62ff00f00572674  |  100.64.1.64  |  subnet-00cdfbc3bc514fece  |
|  aws-K8S-i-00c1b0a868824b4b2|  eni-0e349f79d6e27895f  |  100.64.1.128 |  subnet-00cdfbc3bc514fece  |
|  aws-K8S-i-0b02630e9566d7da8|  eni-09cf45b17f916d63e  |  100.64.3.132 |  subnet-07b15b677debe73a9  |
|  aws-K8S-i-0b02630e9566d7da8|  eni-00eb8007ed6ed0bfe  |  100.64.3.64  |  subnet-07b15b677debe73a9  |
|  aws-K8S-i-0e7275666a52c20f0|  eni-0320731084375bd0f  |  100.64.2.102 |  subnet-014ed3ae44c6f2345  |
|  aws-K8S-i-0e7275666a52c20f0|  eni-03dd19b1f93c1ccf7  |  100.64.2.194 |  subnet-014ed3ae44c6f2345  |
+-----------------------------+-------------------------+---------------+----------------------------+
3、把旧的Nodegroup删除
如果新创建的Nodegroup是采用相同处理器架构的EC2,那么删除旧的Nodegroup时候,原有的Pod会自动漂移到新的Nodegroup上。反之,则要看本应用对应的镜像仓库上是否有分别提供X86_64版本和ARM版本的容器镜像,如果有对应版本的话原有的Pod会自动漂移到新的Nodegroup上,如果没有的话应用Pod会启动失败。
本次实测正是跨架构的情形:待删除的旧节点组使用m6g.2xlarge的Graviton实例,新节点组使用t3.2xlarge的X86_64实例,而集群上运行的nginx、CoreDNS、metrics-server等镜像均为多架构清单(multi-arch manifest)镜像,因此全部Pod都顺利完成了迁移。判定依据是镜像清单中是否包含目标架构,而非节点架构本身是否一致。
删除之前先执行如下命令确认当前集群上的节点组清单,以免误删。
eksctl get nodegroup --cluster eksworkshop --region ap-southeast-1
返回结果如下,其中podsubnet-ng是上一节新建的节点组,另一个则是待删除的旧节点组。旧节点组的名称取决于集群是如何建立的:若按本文第三章创建集群,其名称为managed-ng;若是在此前实验已有的集群上继续操作,则可能是实验三留下的newng。本次实测使用的是后一种情况,因此下方回显中的旧节点组为newng。
CLUSTER		NODEGROUP	STATUS	CREATED			MIN SIZE	MAX SIZE	DESIRED CAPACITY	INSTANCE TYPE	IMAGE ID		TYPE
eksworkshop	newng		ACTIVE	2026-09-18T10:11:23Z	3		6		3			m6g.2xlarge	AL2023_ARM_64_STANDARD	managed
eksworkshop	podsubnet-ng	ACTIVE	2026-09-19T13:40:54Z	3		6		3			t3.2xlarge	AL2023_x86_64_STANDARD	managed
确认清单后执行如下命令删除旧节点组,其中--name参数必须替换为上一步查询到的实际旧节点组名称。
eksctl delete nodegroup --name newng --cluster eksworkshop --region ap-southeast-1
返回结果如下。
2026-09-19 21:46:18 [ℹ]  1 nodegroup (newng) was included (based on the include/exclude rules)
2026-09-19 21:46:18 [ℹ]  will drain 1 nodegroup(s) in cluster "eksworkshop"
2026-09-19 21:46:18 [ℹ]  starting parallel draining, max in-flight of 1
2026-09-19 21:46:20 [ℹ]  cordon node "ip-192-168-17-253.ap-southeast-1.compute.internal"
2026-09-19 21:46:20 [ℹ]  cordon node "ip-192-168-62-144.ap-southeast-1.compute.internal"
2026-09-19 21:46:20 [ℹ]  cordon node "ip-192-168-86-247.ap-southeast-1.compute.internal"
2026-09-19 21:47:18 [✔]  drained all nodes: [ip-192-168-86-247.ap-southeast-1.compute.internal ip-192-168-17-253.ap-southeast-1.compute.internal ip-192-168-62-144.ap-southeast-1.compute.internal]
2026-09-19 21:47:18 [ℹ]  will delete 1 nodegroups from cluster "eksworkshop"
2026-09-19 21:47:19 [ℹ]  1 task: { 1 task: { delete nodegroup "newng" [async] } }
2026-09-19 21:47:20 [ℹ]  will delete stack "eksctl-eksworkshop-nodegroup-newng"
2026-09-19 21:47:20 [✔]  deleted 1 nodegroup(s) from cluster "eksworkshop"
注意:上述命令不接受--approve参数,加上该参数会直接报错cannot use --approve unless a config file is specified via --config-file/-f,因为--approve只在以配置文件方式批量删除节点组时才有意义。
注意:命令输出中标记的[async]表明eksctl只负责提交CloudFormation堆栈的删除请求,随后立即返回,并不等待EC2实例真正终止。实测排空3个节点约耗时1分钟,而节点从kubectl get node中彻底消失还需要数分钟。在这段时间内被排空的节点处于Ready,SchedulingDisabled状态,属于正常现象。被驱逐的Pod会在新节点上重建,原Pod以Completed或Error状态残留,同样属于正常的回收产物,可以忽略。
删除完毕后,即可在新的节点上用新的网络配置启动应用,这时候应用Pod网段将会与Node网段独立开。
五、测试多种ELB部署场景
1、在公有子网部署ALB Ingress并测试从互联网访问
(1)部署应用
构建应用配置文件。
---
apiVersion: v1
kind: Namespace
metadata:
  name: public-alb
---
apiVersion: apps/v1
kind: Deployment
metadata:
  namespace: public-alb
  name: nginx
spec:
  selector:
    matchLabels:
      app.kubernetes.io/name: nginx
  replicas: 3
  template:
    metadata:
      labels:
        app.kubernetes.io/name: nginx
    spec:
      containers:
      - image: public.ecr.aws/nginx/nginx:1.31-alpine-slim
        imagePullPolicy: Always
        name: nginx
        ports:
        - containerPort: 80
---
apiVersion: v1
kind: Service
metadata:
  namespace: public-alb
  name: nginx
spec:
  ports:
    - port: 80
      targetPort: 80
      protocol: TCP
  type: NodePort
  selector:
    app.kubernetes.io/name: nginx
---
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  namespace: public-alb
  name: ingress-for-nginx-app
  labels:
    app: ingress-for-nginx-app
  annotations:
    alb.ingress.kubernetes.io/scheme: internet-facing
    alb.ingress.kubernetes.io/target-type: ip
spec:
  ingressClassName: alb
  rules:
  - http:
      paths:
      - path: /
        pathType: Prefix
        backend:
          service:
            name: nginx
            port:
              number: 80
将上述配置文件保存为public-alb.yaml。然后执行如下命令启动:
kubectl apply -f public-alb.yaml
返回结果:
namespace/public-alb created
deployment.apps/nginx created
service/nginx created
ingress.networking.k8s.io/ingress-for-nginx-app created
(2)查看ALB Ingress入口地址并测试
执行如下命令可查看:
kubectl get ingress -n public-alb
返回结果:
NAME                    CLASS   HOSTS   ADDRESS                                                                       PORTS   AGE
ingress-for-nginx-app   alb     *       k8s-publical-ingressf-e3bf1572ab-655289833.ap-southeast-1.elb.amazonaws.com   80      87s
(3)测试ALB访问
使用浏览器访问上一步获得的ALB的地址,即可看到应用部署成功。也可以在命令行上执行如下命令验证,注意将地址替换为上一步获得的实际地址:
curl -s -m 10 -o /dev/null -w "%{http_code}\n" http://k8s-publical-ingressf-e3bf1572ab-655289833.ap-southeast-1.elb.amazonaws.com/
返回200即表示访问正常。
200
此外可以确认ALB的目标组中注册的是Pod的IP地址,且这些地址全部来自扩展后的Pod子网。执行如下命令:
aws elbv2 describe-target-health --region ap-southeast-1 \
  --target-group-arn $(aws elbv2 describe-target-groups --region ap-southeast-1 --query "TargetGroups[?starts_with(TargetGroupName,'k8s-publical')].TargetGroupArn" --output text) \
  --query 'TargetHealthDescriptions[].{Target:Target.Id,Port:Target.Port,State:TargetHealth.State}' --output text
返回结果如下,三个目标的IP地址均落在100.64.0.0/16范围内。
100.64.1.120	80	healthy
100.64.3.114	80	healthy
100.64.2.25	80	healthy
2、在公有子网创建NLB并通过互联网访问
如果需求方式是网络流量发布而非HTTP请求发布,那么可不使用ALB Ingress,而是使用NLB发布四层端口。前文在创建子网部分已经描述了如何在Subnet上打上EKS的tag,由此EKS会自动找到对应子网。
(1)部署测试应用
构建如下测试应用:
---
apiVersion: v1
kind: Namespace
metadata:
  name: public-nlb
---
apiVersion: apps/v1
kind: Deployment
metadata:
  namespace: public-nlb
  name: nginx-deployment
spec:
  selector:
    matchLabels:
      app.kubernetes.io/name: nginx
  replicas: 3
  template:
    metadata:
      labels:
        app.kubernetes.io/name: nginx
    spec:
      containers:
      - image: public.ecr.aws/nginx/nginx:1.31-alpine-slim
        imagePullPolicy: Always
        name: nginx
        ports:
        - containerPort: 80
---
apiVersion: v1
kind: Service
metadata:
  namespace: public-nlb
  name: "service-nginx"
  annotations:
    service.beta.kubernetes.io/aws-load-balancer-scheme: internet-facing
    service.beta.kubernetes.io/aws-load-balancer-nlb-target-type: ip
spec:
  loadBalancerClass: service.k8s.aws/nlb
  selector:
    app.kubernetes.io/name: nginx
  type: LoadBalancer
  ports:
  - protocol: TCP
    port: 80
    targetPort: 80
将以上配置文件保存为public-nlb.yaml,然后执行如下命令启动:
kubectl apply -f public-nlb.yaml
返回结果:
namespace/public-nlb created
deployment.apps/nginx-deployment created
service/service-nginx created
(2)查看Public NLB的入口地址
查看NLB入口。
kubectl get service service-nginx -n public-nlb -o wide
返回结果如下。
NAME            TYPE           CLUSTER-IP   EXTERNAL-IP                                                                          PORT(S)        AGE   SELECTOR
service-nginx   LoadBalancer   10.50.0.32   k8s-publicnl-servicen-80fe138a1d-3eff4a0322e2f011.elb.ap-southeast-1.amazonaws.com   80:32668/TCP   86s   app.kubernetes.io/name=nginx
即可获得NLB的入口地址。
(3)测试公有NLB
从互联网访问上一步查询出来的NLB入口,可看到访问正常。命令行验证方式如下:
curl -s -m 10 -o /dev/null -w "%{http_code}\n" http://k8s-publicnl-servicen-80fe138a1d-3eff4a0322e2f011.elb.ap-southeast-1.amazonaws.com/
返回200即表示访问正常。
注意:kubectl get service一旦返回了EXTERNAL-IP,只表示AWS Load Balancer Controller已经创建出NLB并写回了DNS名称,并不代表NLB已经可以承载流量。实测在返回地址之后立即访问会得到000,即连接超时,此时查询负载均衡器状态仍为provisioning,目标组中的目标处于initial状态。NLB从创建到active通常需要3至5分钟,应等待其状态变为active之后再进行访问测试。查询状态的命令如下:
aws elbv2 describe-load-balancers --region ap-southeast-1 --query 'LoadBalancers[].{Name:LoadBalancerName,Scheme:Scheme,State:State.Code,Type:Type}' --output table
返回结果如下。
----------------------------------------------------------------------------------------
|                                 DescribeLoadBalancers                                |
+-----------------------------------+------------------+---------------+---------------+
|               Name                |     Scheme       |     State     |     Type      |
+-----------------------------------+------------------+---------------+---------------+
|  k8s-publicnl-servicen-80fe138a1d |  internet-facing |  active       |  network      |
|  myphpdemo                        |  internal        |  active       |  network      |
|  k8s-publical-ingressf-e3bf1572ab |  internet-facing |  active       |  application  |
+-----------------------------------+------------------+---------------+---------------+
3、在私有子网部署只能从内网访问的私有NLB
(1)构建应用和私有NLB配置
在某些模式下,我们只需要对VPC内网或者其他VPC、专线等另一侧暴露内网NLB。因此这时候就不需要构建基于Internet-facing的公网NLB了,而是将NLB配置为私有NLB,其访问入口也只能通过VPC访问。构建如下一段配置:
---
apiVersion: v1
kind: Namespace
metadata:
  name: private-nlb-fixed-ip
---
apiVersion: apps/v1
kind: Deployment
metadata:
  namespace: private-nlb-fixed-ip
  name: nginx-deployment
spec:
  selector:
    matchLabels:
      app.kubernetes.io/name: nginx
  replicas: 3
  template:
    metadata:
      labels:
        app.kubernetes.io/name: nginx
    spec:
      containers:
      - image: public.ecr.aws/nginx/nginx:1.31-alpine-slim
        imagePullPolicy: Always
        name: nginx
        ports:
        - containerPort: 80
---
apiVersion: v1
kind: Service
metadata:
  namespace: private-nlb-fixed-ip
  name: "service-nginx"
  annotations:
    service.beta.kubernetes.io/aws-load-balancer-nlb-target-type: ip
    service.beta.kubernetes.io/aws-load-balancer-name: myphpdemo
    service.beta.kubernetes.io/aws-load-balancer-healthcheck-healthy-threshold: "2"
    service.beta.kubernetes.io/aws-load-balancer-healthcheck-unhealthy-threshold: "2"
    service.beta.kubernetes.io/aws-load-balancer-healthcheck-interval: "10"
    service.beta.kubernetes.io/aws-load-balancer-attributes: load_balancing.cross_zone.enabled=true
    service.beta.kubernetes.io/aws-load-balancer-scheme: internal
    service.beta.kubernetes.io/aws-load-balancer-subnets: subnet-04a7c6e7e1589c953, subnet-031022a6aab9b9e70, subnet-0eaf9054aa6daa68e
    service.beta.kubernetes.io/aws-load-balancer-private-ipv4-addresses: 172.31.48.254, 172.31.64.254, 172.31.80.254
spec:
  loadBalancerClass: service.k8s.aws/nlb
  selector:
    app.kubernetes.io/name: nginx
  type: LoadBalancer
  ports:
  - protocol: TCP
    port: 80
    targetPort: 80
上述配置中与固定IP相关的三条注解需要一并说明。aws-load-balancer-scheme必须为internal,指定固定私有IP的能力只对内网NLB开放。aws-load-balancer-subnets必须显式列出NLB要落地的子网,且每个可用区只能出现一个子网。aws-load-balancer-private-ipv4-addresses所给出的IP数量必须与上一条注解中的子网数量完全一致,并且按相同顺序一一对应,每个IP都必须落在对应子网的CIDR范围之内且当前未被占用。
注意:如果省略aws-load-balancer-subnets注解,AWS Load Balancer Controller会依据子网标签自动发现子网,此时固定IP与子网的对应关系取决于发现顺序,无法由配置文件确定,容易出现IP与子网不匹配而导致NLB创建失败。因此在使用固定私有IP时,这条注解不应省略。
请将上述三个子网ID替换为实际环境中NLB要使用的私有子网ID,并将三个IP地址替换为对应子网内未被占用的地址。将以上配置文件保存为private-nlb.yaml,然后执行如下命令启动:
kubectl apply -f private-nlb.yaml
返回结果:
namespace/private-nlb-fixed-ip created
deployment.apps/nginx-deployment created
service/service-nginx created
(2)查看Private NLB入口地址并测试
查看NLB入口。注意这里的命名空间是private-nlb-fixed-ip,与配置文件名private-nlb.yaml并不相同。
kubectl get service service-nginx -n private-nlb-fixed-ip -o wide
NAME            TYPE           CLUSTER-IP   EXTERNAL-IP                                                   PORT(S)        AGE   SELECTOR
service-nginx   LoadBalancer   10.50.0.98   myphpdemo-6f2657d04b8e43fa.elb.ap-southeast-1.amazonaws.com   80:30098/TCP   85s   app.kubernetes.io/name=nginx
由于配置中使用了aws-load-balancer-name注解指定名称为myphpdemo,因此这里的入口域名以该名称开头,而不是由控制器自动生成的k8s-前缀形式。这个地址将会解析为内网IP。
接下来确认三个固定私有IP是否已经按配置文件中的顺序落到对应子网上。执行如下命令:
aws elbv2 describe-load-balancers --region ap-southeast-1 --names myphpdemo \
  --query 'LoadBalancers[0].{Scheme:Scheme,State:State.Code,AZ:AvailabilityZones[].{Subnet:SubnetId,IP:LoadBalancerAddresses[0].PrivateIPv4Address}}' --output json
返回结果如下,三个私有IP与配置文件中列出的子网严格对应。
{
    "Scheme": "internal",
    "State": "active",
    "AZ": [
        {
            "Subnet": "subnet-053474fb58c51db51",
            "IP": "192.168.96.254"
        },
        {
            "Subnet": "subnet-049ad8896ca32ad98",
            "IP": "192.168.128.254"
        },
        {
            "Subnet": "subnet-0fa9c7b38b01cd9ba",
            "IP": "192.168.160.254"
        }
    ]
}
(3)测试从VPC内访问私有NLB
私有NLB的入口地址只能从VPC内部解析和访问,因此不能在本机上直接测试。可以在集群内临时启动一个带有网络工具的Pod进行验证,执行如下命令,注意将其中的NLB域名与私有IP替换为实际值:
kubectl run vpc-tester --image=public.ecr.aws/docker/library/busybox:1.37 --restart=Never --rm -i --command -- sh -c 'nslookup myphpdemo-6f2657d04b8e43fa.elb.ap-southeast-1.amazonaws.com; wget -q -O - -T 8 http://192.168.128.254/ | head -4'
返回结果如下。域名解析出的三个地址即为上一步配置的固定私有IP,直接以私有IP发起HTTP请求也可以正常取得nginx的首页内容,表明私有NLB工作正常。
Name:	myphpdemo-6f2657d04b8e43fa.elb.ap-southeast-1.amazonaws.com
Address: 192.168.96.254
Name:	myphpdemo-6f2657d04b8e43fa.elb.ap-southeast-1.amazonaws.com
Address: 192.168.128.254
Name:	myphpdemo-6f2657d04b8e43fa.elb.ap-southeast-1.amazonaws.com
Address: 192.168.160.254
<!DOCTYPE html>
<html>
<head>
<title>Welcome to nginx!</title>
pod "vpc-tester" deleted from default namespace
备注:上述命令中的--rm参数会在命令执行结束后自动删除该临时Pod,因此不需要额外清理。
六、确认以上Pod运行在和Node相互独立的网段
上述几个场景的实验完整后,EKS集群上分别有了可从外网访问的ALB Ingress、Public NLB和Private NLB,以及他们背后的应用pod。
现在查看所有pod的IP,可发现除默认负责网络转发的kube-proxy和aws-node(VPC CNI)还运行在Node所在的Subnet上之外,新创建的应用都会运行在新的子网和IP地址段上。如下截图。
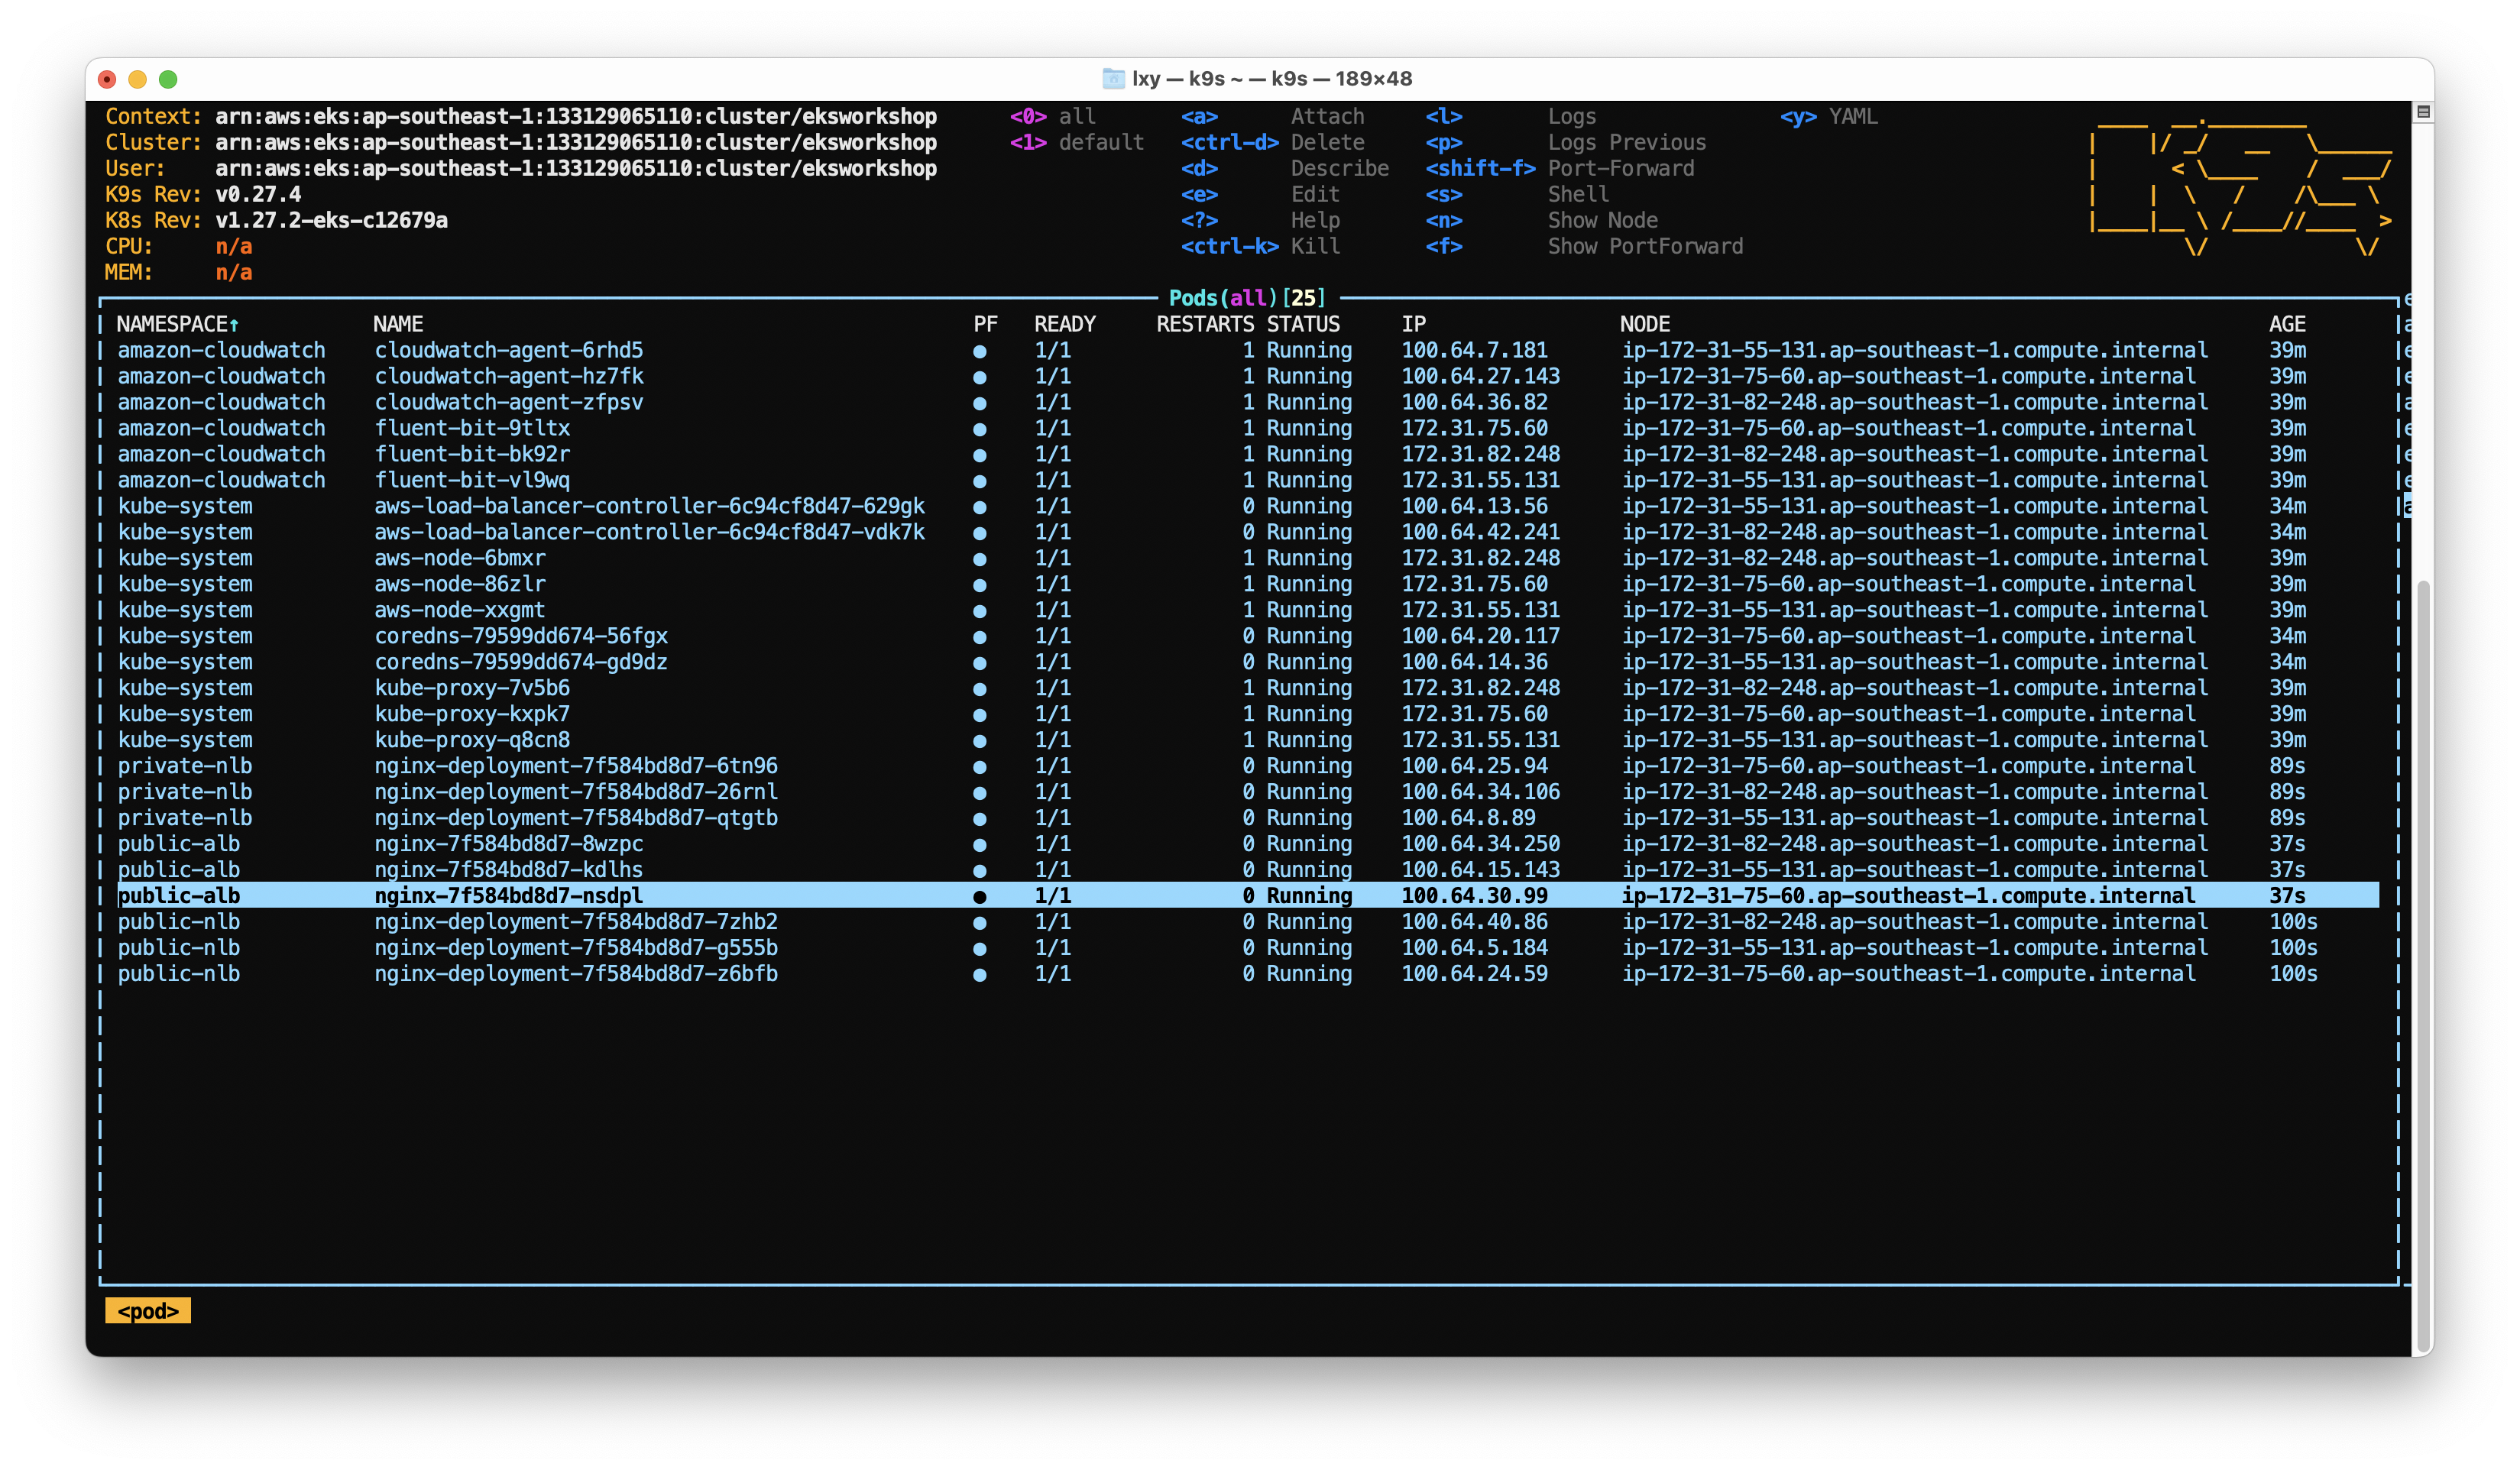
也可以在命令行上按命名空间查看,执行如下命令:
kubectl get pods -A -o wide --no-headers | awk '{printf "%-22s %-48s %s\n", $1, $2, $7}' | sort
返回结果如下,为便于阅读只摘取其中的关键部分。
amazon-cloudwatch      cloudwatch-agent-5lpdw                         192.168.30.108
amazon-cloudwatch      fluent-bit-75f6w                               192.168.54.190
kube-system            aws-load-balancer-controller-6cc6d6bb67-txvst  100.64.1.132
kube-system            aws-node-5wn8p                                 192.168.69.155
kube-system            coredns-7fbc8d5596-p2fns                       100.64.3.78
kube-system            kube-proxy-6t8rx                               192.168.69.155
kube-system            metrics-server-798fdf979c-c7hzz                100.64.2.67
private-nlb-fixed-ip   nginx-deployment-7c95596954-9cc69              100.64.2.108
public-alb             nginx-7c95596954-cdk59                         100.64.2.25
public-nlb             nginx-deployment-7c95596954-ffmvb              100.64.3.168
从这份清单可以读出自定义网络的实际作用范围,这一点比单纯确认应用Pod换了网段更重要。仍然停留在Node网段192.168.0.0/16上的只有四类Pod,分别是aws-node、kube-proxy、cloudwatch-agent和fluent-bit,它们的共同特征是以hostNetwork: true方式运行,直接复用节点主网络接口的IP地址,因此不受自定义网络影响。除此之外的全部Pod都已经改从100.64.0.0/16取得地址,其中不仅包括本次新建的三组测试应用,也包括CoreDNS、metrics-server、AWS Load Balancer Controller这类集群自身的组件,以及此前实验遗留在其他命名空间中的应用Pod。
换言之,自定义网络的生效范围是节点级而非应用级:一旦节点在启用自定义网络之后引导完成,该节点上所有非hostNetwork的Pod都会从Pod子网取得地址,不需要在工作负载的配置中做任何声明。
可以执行如下命令对两个网段的Pod数量做一次汇总核对:
kubectl get pods -A -o wide --no-headers | awk '{print $7}' | cut -d. -f1-2 | grep -E "^(100.64|192.168)" | sort | uniq -c
返回结果如下。
  23 100.64
  11 192.168
七、删除Pod环境(不删除集群和Node)
执行如下命令:
kubectl delete -f private-nlb.yaml
kubectl delete -f public-alb.yaml
kubectl delete -f public-nlb.yaml
返回结果如下。三个命名空间连同其中的Deployment、Service和Ingress一并被删除,对应的ALB与NLB由AWS Load Balancer Controller回收。
namespace "private-nlb-fixed-ip" deleted
deployment.apps "nginx-deployment" deleted from private-nlb-fixed-ip namespace
service "service-nginx" deleted from private-nlb-fixed-ip namespace
namespace "public-alb" deleted
deployment.apps "nginx" deleted from public-alb namespace
service "nginx" deleted from public-alb namespace
ingress.networking.k8s.io "ingress-for-nginx-app" deleted from public-alb namespace
namespace "public-nlb" deleted
deployment.apps "nginx-deployment" deleted from public-nlb namespace
service "service-nginx" deleted from public-nlb namespace
注意:必须先执行上述删除Service的命令,等待ALB与NLB确实被回收之后,才可以删除节点组或整个集群。若跳过此步直接删除集群,Pod子网内残留的弹性网络接口会导致子网与VPC删除失败。可执行如下命令确认负载均衡器已经清空:
aws elbv2 describe-load-balancers --region ap-southeast-1 --query 'LoadBalancers[].LoadBalancerName' --output text
如果后续需要将集群恢复为默认网络模式,即让Pod重新使用Node所在子网的IP地址,需按如下顺序操作。第一步执行如下命令关闭自定义网络:
aws eks update-addon --cluster-name eksworkshop --region ap-southeast-1 \
  --addon-name vpc-cni \
  --configuration-values '{"env":{"AWS_VPC_K8S_CNI_CUSTOM_NETWORK_CFG":"false"}}'
第二步删除ENIConfig资源:
kubectl delete -f eniconfig.yaml
第三步重建节点组。与启用时同理,关闭自定义网络同样只在节点引导阶段生效,既有节点上的Pod不会自动迁回Node子网。
最后一步才是删除Pod子网并解除VPC的扩展CIDR关联。请注意顺序不可颠倒:只有在该CIDR范围内的所有子网都被删除之后,disassociate-vpc-cidr-block命令才会成功,否则会返回依赖冲突的错误。
八、参考文档
Github上的AWS VPC CNI代码和文档:
https://github.com/aws/amazon-vpc-cni-k8s
AWS官方文档,在备用子网中部署Pod的自定义网络说明:
https://docs.aws.amazon.com/eks/latest/userguide/cni-custom-network.html
AWS官方文档,自定义二级网络接口的完整操作教程:
https://docs.aws.amazon.com/eks/latest/userguide/cni-custom-network-tutorial.html
AWS官方文档,Pod IP地址的子网选择方式,含增强子网发现的说明:
https://docs.aws.amazon.com/eks/latest/userguide/cni-subnet-selection.html
AWS EKS最佳实践指南中的自定义网络章节,含Pod数量上限的计算方法:
https://docs.aws.amazon.com/eks/latest/best-practices/custom-networking.html
AWS官方文档,VPC扩展CIDR的限制范围:
https://docs.aws.amazon.com/vpc/latest/userguide/configure-your-vpc.html#add-cidr-block-restrictions
AWS Load Balancer Controller的Service注解完整列表,含固定私有IP的使用限制:
https://kubernetes-sigs.github.io/aws-load-balancer-controller/latest/guide/service/annotations/
AWS Load Balancer Controller的NLB使用说明:
https://kubernetes-sigs.github.io/aws-load-balancer-controller/latest/guide/service/nlb/
最后修改于 2022-04-18